
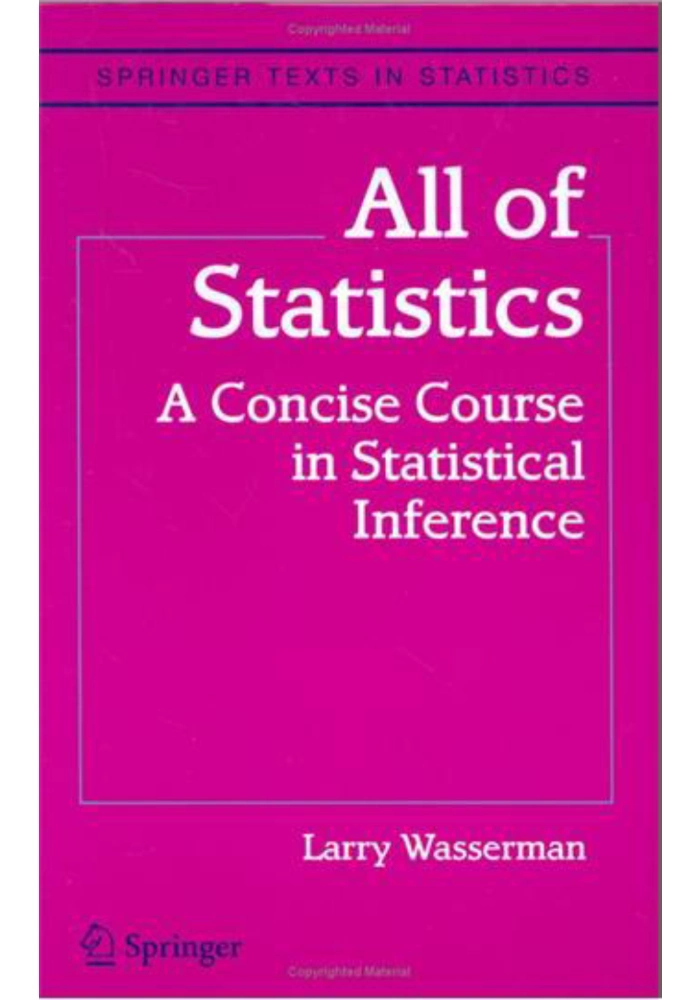

کتاب همه آمار اثر لری واسرمن نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 736 صفحه
- حجم فایل: 8.72 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب All of Statistics اثر Larry Wasserman
All of Statistics: A Concise Course in Statistical Inference اثر Larry Wasserman یک منبع فشرده و جدی برای یادگیری آمار، احتمال و استنباط آماری است. فایل این محصول با نام نویسنده و عنوان مشخص در سایت ثبت شده است. کتاب برای دانشجویان علوم کامپیوتر، آمار، ریاضی، یادگیری ماشین، اقتصاد و پژوهشگرانی مناسب است که میخواهند مجموعهای گسترده از مفاهیم آماری را در یک مسیر منظم و نسبتاً فشرده مرور کنند.
مزیت اصلی این کتاب در آن است که آمار را فقط به مجموعهای از فرمولهای پراکنده تبدیل نمیکند. خواننده باید بفهمد داده چگونه تولید شده، عدم قطعیت از کجا میآید، یک برآوردگر چه ویژگیهایی دارد، فاصله اطمینان چگونه تفسیر میشود و آزمون فرض دقیقاً چه ادعایی را بررسی میکند. همین نگاه برای Machine Learning و Data Science نیز بسیار مهم است، زیرا مدل بدون درک Sampling و Uncertainty میتواند به نتیجهای ظاهراً دقیق اما گمراهکننده منجر شود.
آمار چیست؟
Statistics مجموعهای از روشها برای یادگیری از داده در شرایط عدم قطعیت است. دادهای که مشاهده میکنیم معمولاً نمونهای از یک Process بزرگتر است و هدف این است که با استفاده از Sample درباره Population یا سازوکار تولید داده نتیجهگیری کنیم.
این نتیجهگیری همیشه همراه با Error و Uncertainty است. آمار خوب این عدم قطعیت را پنهان نمیکند، بلکه آن را اندازهگیری و گزارش میکند.
Probability بهعنوان پایه آمار
احتمال زبان رسمی عدم قطعیت است. پیش از ورود به Estimation و Testing باید Event، Sample Space، Conditional Probability و Independence شناخته شوند.
بدون این پایه، بسیاری از Formulaهای استنباطی فقط به دستورهای حفظی تبدیل میشوند.
رویداد و فضای نمونه
Sample Space مجموعه همه Outcomeهای ممکن یک Experiment است و Event زیرمجموعهای از آنهاست. تعریف دقیق فضای نمونه از خطاهای مفهومی جلوگیری میکند.
احتمال شرطی
Conditional Probability احتمال یک Event را با دانستن وقوع Event دیگر توصیف میکند. این مفهوم در Diagnosis، Classification، Bayesian Reasoning و Risk Analysis نقش مرکزی دارد.
استقلال
دو Event مستقلاند اگر دانستن یکی Probability دیگری را تغییر ندهد. استقلال یک فرض قوی است و نباید فقط به دلیل نبود Correlation آن را پذیرفت.
قانون بیز
Bayes Rule امکان بهروزرسانی Probability را پس از مشاهده Evidence فراهم میکند. این رابطه میان Prior، Likelihood و Posterior یکی از مفاهیم بنیادی آمار و Machine Learning است.
متغیر تصادفی
Random Variable خروجی تصادفی را به مقدار عددی نگاشت میکند. Variable میتواند Discrete یا Continuous باشد.
Distribution رفتار احتمالی آن را توصیف میکند.
توزیع احتمال
Distribution مشخص میکند مقدارهای مختلف با چه Probability رخ میدهند. شناخت Distributionهای رایج برای مدلسازی Data و انتخاب روش مناسب مهم است.
Bernoulli و Binomial
Bernoulli برای یک Outcome دودویی و Binomial برای تعداد Success در چند Trial مستقل استفاده میشود. این مدلها برای Conversion، Defect و آزمایشهای دوحالته کاربرد دارند.
Poisson
Poisson اغلب برای Count Event در یک Interval استفاده میشود، البته زمانی که فرضهای مدل با Process واقعی سازگار باشند.
Normal Distribution
Normal Distribution در آمار نقش بزرگی دارد، اما نباید فرض شود همه Dataها Normal هستند. اهمیت آن تا حد زیادی به Central Limit Theorem و Approximationهای استنباطی مربوط است.
Expectation
Expected Value میانگین نظری Random Variable است. این Quantity در Risk، Decision Theory و بسیاری از Derivationهای آماری ظاهر میشود.
Variance
Variance میزان پراکندگی حول Mean را اندازه میگیرد. Standard Deviation ریشه Variance است و Unit اصلی Variable را حفظ میکند.
Covariance
Covariance نشان میدهد دو Variable چگونه با هم تغییر میکنند. Scale آن به Unitها وابسته است و همین موضوع تفسیر مستقیم را دشوار میکند.
Correlation
Correlation نسخه Scale-free از ارتباط خطی است. مقدار نزدیک صفر لزوماً به معنی نبود هرگونه رابطه نیست، زیرا Relation ممکن است Nonlinear باشد.
Joint Distribution
برای چند Variable باید Distribution مشترک آنها بررسی شود. Marginal و Conditional Distribution از Joint Distribution استخراج میشوند.
قانون اعداد بزرگ
Law of Large Numbers توضیح میدهد چرا Average نمونه با افزایش تعداد Observationها به Expected Value نزدیک میشود، تحت شرایط مناسب.
این مفهوم پایه بسیاری از Intuitionهای آماری است.
قضیه حد مرکزی
Central Limit Theorem یکی از مهمترین نتایج Probability است. در شرایط مشخص، Distribution مناسب از مجموع یا Mean نمونه با افزایش Sample Size به Normal نزدیک میشود.
این موضوع دلیل استفاده گسترده از Approximationهای Normal در Inference است.
Sampling Distribution
اگر از Population بارها Sample بگیریم، Statisticی مانند Mean هر بار کمی متفاوت خواهد بود. Distribution این Statistic همان Sampling Distribution است.
Inference بر اساس همین Variation ساخته میشود.
Estimator
Estimator قاعدهای برای تخمین Parameter ناشناخته از Data است. Sample Mean نمونهای ساده از Estimator برای Population Mean است.
Bias
Bias تفاوت سیستماتیک میان Expected Value برآوردگر و Parameter واقعی را نشان میدهد. Estimator بدون Bias همیشه بهترین Estimator نیست؛ Variance نیز اهمیت دارد.
Variance of Estimator
دو Estimator ممکن است Bias مشابه اما Stability متفاوت داشته باشند. Estimator با Variance کمتر در Sampleهای مختلف کمتر نوسان میکند.
Bias-Variance Trade-off
گاهی کمی Bias میتواند Variance را به شکل قابل توجهی کاهش دهد. این Trade-off در Statistics و Machine Learning بسیار مهم است.
Consistency
Estimator سازگار با افزایش Sample Size به Parameter واقعی نزدیک میشود. Consistency یک ویژگی Asymptotic است.
Maximum Likelihood
Maximum Likelihood Estimation پارامتری را انتخاب میکند که Data مشاهدهشده را تحت Model بیشترین Likelihood بدهد.
این روش در مدلهای آماری و Machine Learning کاربرد گستردهای دارد.
Likelihood و Probability
Probability با Parameter ثابت درباره Data صحبت میکند، در حالی که Likelihood با Data ثابت Parameterهای مختلف را مقایسه میکند. این تفاوت مفهومی مهم است.
روش گشتاورها
Method of Moments از Momentهای Sample برای تخمین Parameter استفاده میکند. این روش گاهی سادهتر از Maximum Likelihood است.
فاصله اطمینان
Confidence Interval یک Range برای Parameter ارائه میدهد که با Procedure نمونهگیری مشخص ساخته شده است.
تفسیر آن باید دقیق باشد؛ Interval یک Statement درباره عملکرد روش در تکرار Sampling است، نه الزاماً Probability سادهای درباره Parameter ثابت.
Standard Error
Standard Error میزان Variation یک Estimator در Samplingهای تکراری را نشان میدهد. با Standard Deviation داده خام متفاوت است.
آزمون فرض
Hypothesis Testing روشی برای سنجش Evidence علیه یک Null Hypothesis است. Null و Alternative باید پیش از دیدن Result تا حد امکان روشن باشند.
p-value
p-value احتمال مشاهده Result به اندازه Result فعلی یا Extremeتر تحت فرض Null است. p-value احتمال درست بودن Null Hypothesis نیست.
این سوءبرداشت یکی از خطاهای رایج در گزارش پژوهش است.
Type I Error
Type I Error زمانی رخ میدهد که Null درست باشد اما Reject شود. سطح Significance احتمال کنترلشده چنین Errorی را در چارچوب آزمون مشخص میکند.
Type II Error
Type II Error زمانی است که Alternative واقعی وجود دارد اما Test آن را شناسایی نمیکند.
Power
Power احتمال Detect کردن Effect واقعی است. Sample Size، Effect Size، Noise و Threshold آزمون بر Power اثر دارند.
Effect Size
Statistical Significance به تنهایی کافی نیست. باید اندازه Effect نیز گزارش شود تا Practical Importance مشخص باشد.
Multiple Testing
وقتی تعداد زیادی Hypothesis همزمان تست میشوند، احتمال False Positive افزایش مییابد. Correction یا روشهای کنترل Error Rate لازم میشوند.
Bootstrap
Bootstrap از Resampling داده مشاهدهشده برای تقریب Sampling Distribution استفاده میکند. این روش برای Standard Error، Confidence Interval و بعضی Estimateهای پیچیده بسیار مفید است.
Resampling
Resampling کمک میکند بدون Derivation تحلیلی بسیار پیچیده، رفتار Statistic بررسی شود. با این حال کیفیت Result به Representativeness Sample وابسته است.
Permutation Tests
Permutation Test با جابهجایی Label یا Assignment تحت Null Distribution مرجع میسازد. این روش در بعضی مسائل Alternative خوبی برای Approximation پارامتری است.
Nonparametric Methods
روشهای Nonparametric فرضهای کمتری درباره شکل Distribution دارند. این انعطاف معمولاً با Trade-offهای خاصی همراه است.
Empirical Distribution Function
ECDF Distribution تجربی Sample را نشان میدهد و ابزار ساده اما قدرتمندی برای فهم Data است.
Density Estimation
Density Estimation تلاش میکند شکل Distribution پیوسته را از Sample تخمین بزند. انتخاب Bandwidth در روشهای Smooth اهمیت زیادی دارد.
Regression
Regression رابطه میان Response و Predictorها را مدل میکند. Linear Regression یکی از پایهایترین مدلهای آماری است.
هدف فقط Fit کردن Line نیست؛ Assumptionها، Uncertainty و Residualها نیز باید بررسی شوند.
Linear Regression
در مدل خطی، Response به ترکیبی خطی از Featureها و Error نسبت داده میشود. Coefficientها اثر شرطی Predictorها را تحت Model توصیف میکنند.
Residual Analysis
Residualها تفاوت Prediction و Observation هستند. Pattern در Residual میتواند Nonlinearity، Heteroscedasticity یا Model Misspecification را نشان دهد.
Multicollinearity
وقتی Predictorها همبستگی زیادی دارند، تخمین Coefficientها میتواند ناپایدار شود. Prediction ممکن است همچنان خوب باشد، اما Interpretation دشوارتر میشود.
Model Selection
انتخاب Model نباید فقط بر Training Fit تکیه کند. Complexity و Generalization باید در نظر گرفته شوند.
Overfitting
Model بسیار انعطافپذیر ممکن است Noise Sample را یاد بگیرد. نتیجه Training عالی و Out-of-Sample ضعیف خواهد بود.
Underfitting
Model خیلی ساده Pattern اصلی را نیز capture نمیکند. انتخاب Complexity مناسب نیازمند Validation است.
Prediction Error
هدف Prediction اندازهگیری Performance روی Data جدید است. Training Error معمولاً Estimate خوشبینانهای از این Performance است.
Cross-Validation
Cross-Validation داده را چند بار به Train و Validation تقسیم میکند تا Performance Out-of-Sample بهتر تخمین زده شود.
Classification
در Classification هدف پیشبینی Category است. Probability Prediction و Decision Threshold دو مفهوم جدا هستند.
Logistic Regression
Logistic Regression Probability یک Outcome دودویی را مدل میکند و یکی از مدلهای پایه Classification است.
Confusion Matrix
Confusion Matrix نشان میدهد Positive و Negative چگونه درست یا اشتباه پیشبینی شدهاند. Accuracy به تنهایی برای Dataset نامتوازن کافی نیست.
Precision و Recall
Precision کیفیت Predictionهای Positive و Recall میزان پوشش Positiveهای واقعی را نشان میدهد. Trade-off آنها به کاربرد بستگی دارد.
ROC و AUC
ROC رفتار Classifier را روی Thresholdهای مختلف نشان میدهد. AUC خلاصهای از Ranking Performance ارائه میکند، اما باید با Context مسئله تفسیر شود.
Bayesian Inference
در دیدگاه Bayesian، Prior همراه Likelihood به Posterior تبدیل میشود. Posterior عدم قطعیت درباره Parameter را پس از مشاهده Data توصیف میکند.
Prior
Prior باید شفاف باشد و Sensitivity Result نسبت به انتخاب آن بررسی شود، بهخصوص زمانی که Data محدود است.
Posterior
Posterior پایه Prediction و تصمیمگیری Bayesian است. محاسبه آن در Modelهای پیچیده ممکن است به Approximation نیاز داشته باشد.
Frequentist و Bayesian
این دو Framework تفسیر متفاوتی از Probability و Parameter دارند. بهتر است به جای مقایسه شعاری، Assumption و کاربرد هر روش فهمیده شود.
Causal Inference و Association
Association آماری به تنهایی Causality را اثبات نمیکند. برای ادعای علّی باید Design مطالعه، Confounding و Assignment Mechanism بررسی شوند.
Confounding
Confounder میتواند رابطه ظاهری میان دو Variable ایجاد کند. Randomization یکی از ابزارهای قدرتمند برای کاهش Confounding در Experiment است.
Randomized Experiments
Random Assignment کمک میکند گروهها از نظر عاملهای شناختهشده و ناشناخته قابل مقایسهتر شوند. این موضوع Basis استنباط علّی قوی است.
Observational Data
در داده Observational کنترل Confounding دشوارتر است و نتیجه علّی نیازمند Assumptionهای بیشتری خواهد بود.
Missing Data
Missingness ممکن است تصادفی یا Systematic باشد. حذف ساده Rowهای ناقص همیشه بیخطر نیست.
Outliers
Outlier میتواند Error، Observation واقعی نادر یا نشانه Model نامناسب باشد. حذف آن بدون بررسی علمی درست نیست.
Robust Statistics
روشهای Robust تلاش میکنند حساسیت Estimate به Observationهای Extreme را کاهش دهند.
Data Transformation
Log Transform یا Standardization میتواند Model را مناسبتر کند، اما باید دلیل Transformation و اثر آن بر Interpretation روشن باشد.
Standardization
قرار دادن Variableها روی Scale مشترک در بعضی Algorithmها و Regularization مفید است. برای همه Modelها الزام یکسانی ندارد.
High-Dimensional Data
وقتی تعداد Featureها زیاد است، روشهای کلاسیک با چالشهای جدید روبهرو میشوند. Overfitting و Multiple Comparison اهمیت بیشتری پیدا میکنند.
Regularization
Regularization Complexity Model را کنترل میکند. Bias کمی اضافه میشود تا Variance و Overfitting کاهش یابد.
Feature Selection
انتخاب Feature باید با هدف Prediction یا Interpretation هماهنگ باشد. انتخاب بر اساس همان Data میتواند Uncertainty اضافی ایجاد کند.
Curse of Dimensionality
در Dimension بالا، داده Sparse میشود و Intuition هندسی تغییر میکند. بسیاری از روشهای مبتنی بر Distance تحت تأثیر قرار میگیرند.
Density در Dimension بالا
تخمین Density در Dimension زیاد دشوار است و به Sample بسیار بیشتری نیاز دارد. این موضوع یکی از دلایل استفاده از Structure و Regularization است.
Statistical Decision Theory
Decision را میتوان با Loss Function و Expected Risk فرموله کرد. این نگاه Probability Prediction را به Action واقعی متصل میکند.
Loss Function
Loss مشخص میکند Errorهای مختلف چه هزینهای دارند. در مسائل واقعی False Positive و False Negative ممکن است هزینه برابر نداشته باشند.
Risk
Expected Risk میانگین Loss تحت Distribution داده است. هدف بسیاری از روشهای یادگیری کاهش همین Quantity است.
Empirical Risk
چون Distribution واقعی ناشناخته است، Risk معمولاً با Sample تخمین زده میشود. تفاوت Empirical و True Risk اساس Generalization است.
Uncertainty Quantification
Prediction بدون بیان Uncertainty میتواند بیش از حد مطمئن به نظر برسد. Interval، Standard Error و Probability ابزارهایی برای بیان عدم قطعیت هستند.
Data Leakage
اگر اطلاعات Test یا آینده وارد Training شوند، Evaluation غیرواقعی میشود. Preprocessing نیز باید داخل Split مناسب انجام شود.
Train، Validation و Test
Training برای Fit، Validation برای انتخاب Model و Test برای ارزیابی نهایی استفاده میشود. استفاده مکرر از Test Set استقلال آن را از بین میبرد.
Reproducibility
Data Version، Code، Random Seed و Analysis Decisions باید ثبت شوند تا نتیجه قابل تکرار باشد.
Visualization
پیش از Model پیچیده باید Data دیده شود. Histogram، Scatter Plot، Box Plot و ECDF میتوانند مشکلهایی را نشان دهند که Summary Number پنهان میکند.
Exploratory Data Analysis
EDA برای کشف Pattern و مشکل Data مفید است، اما Hypothesisهایی که پس از مشاهده Data ساخته شدهاند نباید به شکل Confirmatory بدون Validation گزارش شوند.
Simulation
Simulation ابزار مهمی برای فهم Distribution و Procedureهای آماری است. میتوان Coverage، Bias و Type I Error را در شرایط کنترلشده بررسی کرد.
Asymptotics
بسیاری از نتایج آماری برای Sample بزرگ Approximation ارائه میکنند. در Sample کوچک باید درباره اعتبار Approximation محتاط بود.
Finite-Sample Behavior
عملکرد واقعی Method در Sample محدود ممکن است با نتیجه Asymptotic تفاوت داشته باشد. Simulation و Exact Result میتوانند کمک کنند.
Assumptions
هر روش آماری Assumption دارد. Independence، Distribution Form یا Sampling Mechanism نمونههایی هستند که باید بررسی شوند.
Model Misspecification
اگر Model با Data Generation Process ناسازگار باشد، Estimate و Uncertainty میتوانند گمراهکننده شوند.
Interpretation
Coefficient، p-value یا Probability باید در Context درست تفسیر شوند. عدد بدون تعریف و Assumption معنای کامل ندارد.
ارتباط با Machine Learning
Machine Learning بسیاری از ایدههای Statistics را به کار میگیرد: Risk، Regularization، Cross-Validation، Bias-Variance و Probability Modeling. این کتاب پایه نظری مناسبی برای فهم این مفاهیم فراهم میکند.
ارتباط با Data Science
Data Science فقط ساخت Model نیست. Sampling، Measurement، Uncertainty و Experiment Design تعیین میکنند آیا Data اصلاً میتواند سؤال موردنظر را جواب دهد یا نه.
روش مطالعه پیشنهادی
بهتر است هر Definition با مثال کوچک همراه شود و Formulaها صرفاً حفظ نشوند. برای Distributionها Simulation بسازید و برای Estimatorها Bias و Variance را تجربی بررسی کنید.
پس از هر Topic، سؤال کنید Assumption چیست، اگر نقض شود چه اتفاقی میافتد و Result چگونه باید تفسیر شود.
این کتاب برای چه کسانی مناسب است؟
- دانشجویان آمار، ریاضی و علوم کامپیوتر.
- علاقهمندان Machine Learning و Data Science.
- پژوهشگرانی که به استنباط آماری نیاز دارند.
- افرادی که Probability را میدانند و یک مرور فشرده اما جدی از Statistics میخواهند.
- برنامهنویسانی که میخواهند پشتوانه نظری تحلیل داده را بهتر بفهمند.
جمعبندی
All of Statistics اثر Larry Wasserman یک مسیر فشرده از Probability به Statistical Inference ارائه میدهد. Random Variable، Distribution، Estimation، Confidence Interval، Hypothesis Testing، Bootstrap، Regression، Classification، Bayesian Inference و روشهای Nonparametric از مفاهیم مهم این حوزه هستند.
ارزش کتاب در ایجاد دیدی منظم نسبت به عدم قطعیت است. خواننده یاد میگیرد هر Estimate از Sample آمده، هر Test محدودیت دارد و هر Model بر Assumptionهایی متکی است. برای کسی که میخواهد Statistics را بهعنوان پایه Machine Learning، Data Science یا پژوهش علمی جدیتر بفهمد، این اثر یک مرجع فشرده و مفهومی ارزشمند است.



نقد و بررسیها
هنوز بررسیای ثبت نشده است.