
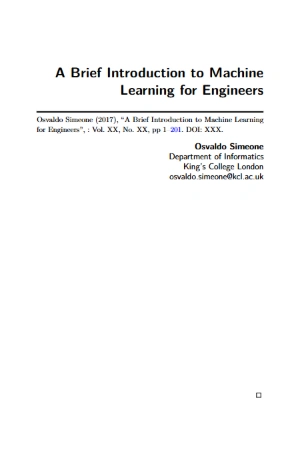

کتاب یادگیری ماشین برای مهندسان نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 206 صفحه
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب Intro to Machine Learning for Engineers
Intro to Machine Learning for Engineers یک منبع آموزشی برای مهندسانی است که میخواهند یادگیری ماشین را از زاویه حل مسئله، مدلسازی داده و پیادهسازی عملی یاد بگیرند. فایل این محصول به زبان انگلیسی و 206 صفحه ثبت شده است. تمرکز اصلی آن روی مفاهیم پایه Machine Learning، آمادهسازی داده، ساخت مدل، ارزیابی و نحوه استفاده از الگوریتمها در مسائل مهندسی است.
برای یک مهندس، یادگیری ماشین زمانی ارزشمند میشود که بتواند از داده برای پیشبینی، طبقهبندی، تخمین و تصمیمگیری استفاده کند. به همین دلیل این کتاب به جای پرداختن صرف به فرمولهای نظری، تلاش میکند بین ریاضیات، الگوریتم و کاربرد واقعی ارتباط برقرار کند.
یادگیری ماشین از دید مهندسی
در مسائل مهندسی معمولاً با داده Sensor، اندازهگیری، Signal، زمان، خطا، فرآیند و سیستم سروکار داریم. Machine Learning کمک میکند Patternهایی پیدا کنیم که در مدلهای تحلیلی ساده دیده نمیشوند. با این حال مدل دادهمحور باید با محدودیتهای فیزیکی و Context مسئله هماهنگ باشد.
یکی از نکات مهم این است که مدل خوب فقط Accuracy بالا نیست. Stability، Interpretability، Robustness و هزینه محاسباتی نیز ممکن است در سیستم مهندسی مهم باشند.
Supervised Learning
در Supervised Learning داده شامل Feature و Target است. مدل از نمونههای گذشته یاد میگیرد و سپس برای داده جدید Prediction تولید میکند. Regression و Classification دو شاخه اصلی این نوع یادگیری هستند.
برای مثال پیشبینی دمای آینده یا عمر باقیمانده تجهیز یک مسئله Regression و تشخیص سالم یا معیوب بودن قطعه یک مسئله Classification است.
Regression
Regression زمانی استفاده میشود که خروجی مقدار پیوسته باشد. Linear Regression یکی از سادهترین مدلهاست و نقطه شروع مناسبی برای ساخت Baseline محسوب میشود.
در مسائل پیچیدهتر ممکن است از Polynomial Model، Tree، Ensemble یا Neural Network استفاده شود. اما مدل پیچیدهتر فقط زمانی ارزش دارد که روی داده جدید واقعاً بهتر عمل کند.
Classification
Classification برای پیشبینی Class یا Category استفاده میشود. Logistic Regression، Decision Tree، SVM و KNN از الگوریتمهای رایج هستند.
در سیستمهای مهندسی Class ممکن است نشاندهنده Failure Mode، وضعیت دستگاه یا نوع Signal باشد. انتخاب Metric باید با هزینه واقعی خطا هماهنگ شود.
Feature Engineering
Feature Engineering نقش مهمی در پروژههای مهندسی دارد. از Signal خام میتوان Mean، Variance، Frequency Component، Peak، Trend یا نسبتهای مختلف استخراج کرد.
Feature خوب باید اطلاعات مفید درباره Target داشته باشد و هنگام Deployment نیز قابل محاسبه باشد. استفاده از اطلاعات آینده یا Target Leakage باعث Evaluation غیرواقعی میشود.
Train و Test
برای سنجش Generalization باید داده به بخش Training و Test تقسیم شود. مدل فقط با Training Data آموزش میبیند و Test برای ارزیابی نهایی نگه داشته میشود.
در داده زمانی باید ترتیب حفظ شود. Random Split ممکن است آینده را وارد Training کند و نتیجه را بیش از حد خوشبینانه نشان دهد.
Validation
برای انتخاب Hyperparameter از Validation استفاده میشود. اگر Test Data بارها برای تنظیم مدل استفاده شود، دیگر معیار مستقل مناسبی نیست.
Cross-Validation در Datasetهای مستقل از زمان روش رایجی است، اما برای Time Series باید از روشهای سازگار با ترتیب زمانی استفاده کرد.
Overfitting
Overfitting زمانی رخ میدهد که مدل جزئیات Training Data را بیش از حد یاد بگیرد. نتیجه Training عالی و عملکرد ضعیف روی داده جدید است.
Regularization، کاهش Complexity، داده بیشتر و Validation مناسب از ابزارهای کنترل Overfitting هستند.
Underfitting
Underfitting زمانی است که مدل حتی Pattern اصلی Training Data را هم یاد نمیگیرد. دلیل میتواند مدل بسیار ساده، Feature نامناسب یا Training ناکافی باشد.
تشخیص تفاوت Overfitting و Underfitting برای انتخاب اقدام اصلاحی اهمیت دارد.
Scaling
الگوریتمهایی مانند SVM، KNN و مدلهای مبتنی بر Gradient به Scale Featureها حساساند. Standardization و Normalization از روشهای متداولاند.
Scaler باید فقط روی Training Data Fit شود تا اطلاعات Test وارد Training نشود.
Decision Trees
Decision Tree با مجموعهای از Splitهای شرطی داده را تقسیم میکند. مزیت آن تفسیرپذیری نسبی و توانایی مدلسازی روابط غیرخطی است.
Tree عمیق میتواند Overfit کند، بنابراین Depth و Minimum Samples باید کنترل شوند.
Ensemble Learning
ترکیب چند Model میتواند پایداری و Accuracy را افزایش دهد. Random Forest و Gradient Boosting از روشهای شناختهشده هستند.
در مسائل مهندسی Ensemble زمانی مفید است که Dataset پیچیده باشد و یک مدل ساده نتواند همه Patternها را پوشش دهد.
Support Vector Machine
SVM تلاش میکند مرزی با Margin مناسب میان Classها پیدا کند. Kernel امکان مدلسازی مرزهای غیرخطی را فراهم میکند.
Scaling و تنظیم C و Kernel Parameterها برای عملکرد SVM مهم هستند.
K-Nearest Neighbors
KNN نمونه جدید را بر اساس نزدیکترین نمونههای Training طبقهبندی یا تخمین میزند. مدل ساده است اما Prediction روی Dataset بزرگ میتواند پرهزینه باشد.
Distance Metric و Scaling Featureها اثر زیادی روی نتیجه دارند.
Unsupervised Learning
در Unsupervised Learning Label مشخص نداریم. Clustering و کاهش ابعاد برای کشف ساختار داده استفاده میشوند.
در پروژه مهندسی این روشها برای شناسایی Operating Mode، Anomaly یا ساخت Featureهای جدید کاربرد دارند.
K-Means
K-Means داده را به K Cluster تقسیم میکند و تلاش میکند فاصله نمونهها از Center خوشه خود را کم کند.
انتخاب K و Scale داده مهم است و نتیجه Cluster باید با Context مهندسی تفسیر شود.
PCA
Principal Component Analysis ابعاد داده را با ساخت ترکیبهای خطی جدید کاهش میدهد. Componentهای اول بیشترین Variance را حفظ میکنند.
PCA برای Visualization، کاهش Noise و کاهش تعداد Featureها مفید است، اما Interpretation Componentها همیشه ساده نیست.
Evaluation Metrics
در Regression میتوان از MAE، MSE و RMSE استفاده کرد. در Classification Accuracy، Precision، Recall و F1 رایجاند.
در مسئله مهندسی باید Metric بر اساس هزینه واقعی خطا انتخاب شود. از دست دادن Fault ممکن است بسیار مهمتر از False Alarm باشد.
Confusion Matrix
Confusion Matrix مشخص میکند هر Class با کدام Class اشتباه میشود. این اطلاعات برای تحلیل Failure Mode مدل بسیار ارزشمند است.
به جای تمرکز فقط روی یک Accuracy کلی، باید نمونههای اشتباه بررسی شوند.
Data Quality
کیفیت مدل مستقیماً به کیفیت داده وابسته است. Sensor Noise، Missing Value، Drift و Calibration Error میتوانند مدل را خراب کنند.
مهندس باید قبل از Training منشأ داده و شرایط اندازهگیری را بشناسد.
Data Leakage
Leakage زمانی رخ میدهد که اطلاعاتی وارد Feature شود که در زمان Prediction واقعی در دسترس نیست. نتیجه Validation عالی و Deployment ضعیف است.
در داده صنعتی، Leakage میتواند از Timestamp، Maintenance Record یا اطلاعات پس از Failure ایجاد شود.
Pipeline
یک Pipeline حرفهای شامل Data Cleaning، Feature Engineering، Scaling، Model و Evaluation است. این مراحل باید قابل تکرار باشند.
در Production همان Preprocessing دوره Training باید دقیقاً اجرا شود.
Deployment
مدل مهندسی در نهایت باید روی سیستم واقعی اجرا شود. Latency، Memory، Reliability و Monitoring بخشی از طراحی هستند.
اگر مدل روی Edge Device اجرا شود، محدودیت Hardware میتواند Architecture را تعیین کند.
Monitoring
Distribution داده ممکن است در طول زمان تغییر کند. Sensor جدید، فرسودگی تجهیز یا تغییر Process میتواند Data Drift ایجاد کند.
Monitoring کمک میکند کاهش عملکرد مدل قبل از ایجاد مشکل جدی تشخیص داده شود.
این کتاب برای چه کسانی مناسب است؟
- مهندسان برق، مکانیک، صنایع و کامپیوتر.
- دانشجویانی که میخواهند Machine Learning را کاربردی یاد بگیرند.
- افرادی که با داده Sensor و سیستمهای واقعی کار میکنند.
- برنامهنویسانی که میخواهند Workflow کامل مدلسازی را بفهمند.
- کسانی که به Predictive Maintenance و Data-Driven Engineering علاقه دارند.
جمعبندی
Intro to Machine Learning for Engineers منبعی برای آشنایی با Machine Learning از دید مهندسی است. کتاب مفاهیمی مانند Regression، Classification، Feature Engineering، Validation، Ensemble، Clustering و Evaluation را در قالب یک مسیر عملی بررسی میکند.
ارزش اصلی آن در نگاه سیستماتیک به پروژه است: داده، مدل، Metric، محدودیتهای واقعی و Deployment باید کنار هم دیده شوند. برای مهندسی که میخواهد از داده برای حل مسئله واقعی استفاده کند، این کتاب نقطه شروع مناسبی است.





نقد و بررسیها
هنوز بررسیای ثبت نشده است.