
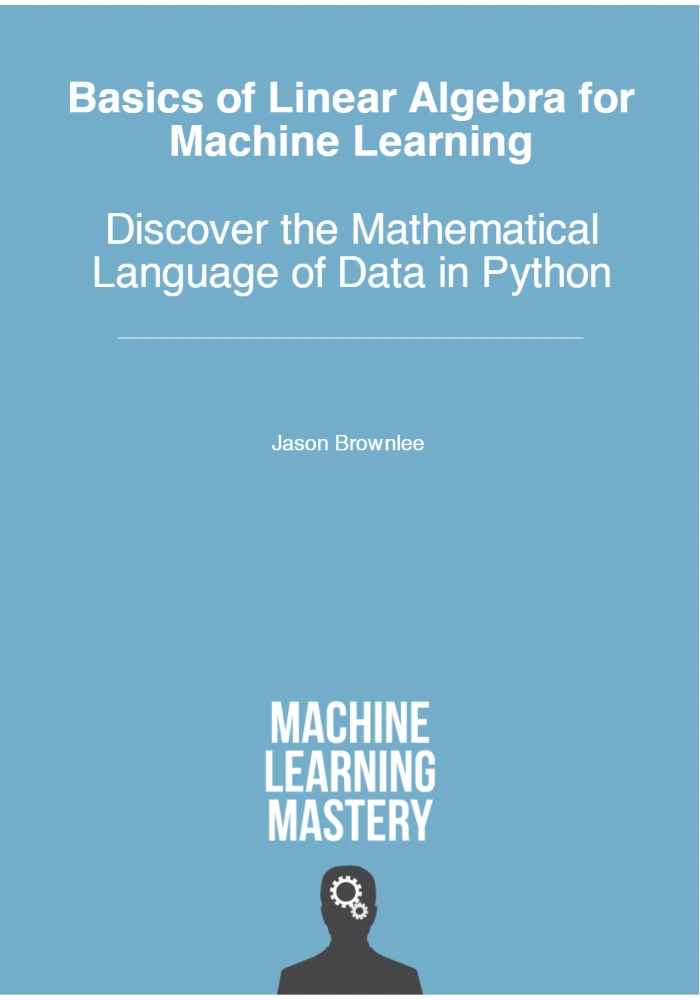

کتاب جبر خطی برای یادگیری ماشین نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب Basics of Linear Algebra for Machine Learning
Basics of Linear Algebra for Machine Learning: Discover the Mathematical Language of Data in Python اثر Jason Brownlee یک راهنمای کاربردی برای یادگیری جبر خطی با تمرکز مستقیم بر Machine Learning و Data Science است. این کتاب تلاش میکند مفاهیمی مانند Vector، Matrix، Tensor، Matrix Decomposition، Eigenvalue، SVD و PCA را از حالت کاملاً انتزاعی خارج کند و نشان دهد این ابزارها چگونه در پیادهسازی الگوریتمهای یادگیری ماشین و تحلیل داده استفاده میشوند.
اگر هنگام مطالعه Machine Learning با عبارتهایی مانند dot product، matrix multiplication، covariance matrix، eigenvector، singular value decomposition یا projection روبهرو شدهاید و احساس میکنید فرمولها از منطق مسئله جدا هستند، این کتاب برای ساختن همان پل میان ریاضیات و Code مناسب است. تأکید اثر بر Python و NumPy کمک میکند Conceptها فقط روی کاغذ باقی نمانند و با آرایههای واقعی اجرا شوند.
چرا جبر خطی برای یادگیری ماشین ضروری است؟
بیشتر Dataهایی که به Model وارد میشوند در نهایت به Vector، Matrix یا Tensor تبدیل میشوند. یک رکورد Tabular را میتوان Vector Featureها در نظر گرفت، مجموعه نمونهها یک Matrix میسازد و Image یا Batch داده معمولاً Tensor چندبعدی است.
بنابراین Linear Algebra زبان طبیعی Representation و Transformation داده در Machine Learning است.
Scalar چیست؟
Scalar یک مقدار عددی منفرد است. Learning Rate، Bias، Loss نهایی یا یک Feature ساده میتواند Scalar باشد.
اگرچه مفهوم Scalar ساده است، رابطه آن با Vector و Matrix برای فهم Dimension و Shape مهم است.
Vector چیست؟
Vector مجموعه مرتبشدهای از عددهاست که میتواند Featureهای یک نمونه، Direction یا Point را نمایش دهد.
در Machine Learning، یک نمونه با n ویژگی اغلب به شکل Vector در فضای nبعدی نمایش داده میشود.
Vector Addition
دو Vector با Dimension یکسان میتوانند Element-wise جمع شوند. این Operation در Update Parameterها و Transformationها دیده میشود.
Scalar Multiplication
ضرب Vector در Scalar Magnitude را تغییر میدهد. در Gradient Descent، Learning Rate در Gradient ضرب میشود و اندازه Update را تعیین میکند.
Dot Product
Dot Product دو Vector را به Scalar تبدیل میکند. این Operation در Linear Model، Similarity، Projection و Neural Network بسیار رایج است.
اگر Vectorها Normalize شده باشند، Dot Product با Cosine Similarity ارتباط مستقیم دارد.
Vector Norm
Norm اندازه یا طول Vector را مشخص میکند. L1 و L2 Norm در Optimization و Regularization نقش مهمی دارند.
L2 distance یکی از Metricهای رایج برای فاصله است، اما Scale Featureها روی آن اثر میگذارد.
Matrix چیست؟
Matrix آرایه دوبعدی از عددهاست. Dataset با m نمونه و n Feature را میتوان Matrix با Shape m×n در نظر گرفت.
Matrix فقط Container داده نیست؛ Transformation خطی نیز با Matrix نمایش داده میشود.
Shape
Shape مشخص میکند Array در هر Dimension چه اندازهای دارد. بخش زیادی از Errorهای پیادهسازی ML ناشی از ناسازگاری Shape است.
فهم دقیق Rows، Columns، Samples و Features یکی از مهارتهای پایه کار با NumPy است.
Matrix Addition
جمع Matrixها نیازمند Shape یکسان است و بهصورت Element-wise انجام میشود. این Operation با Matrix Multiplication متفاوت است.
Element-wise Multiplication
ضرب Element-wise هر عنصر را با عنصر متناظر ضرب میکند. در NumPy معمولاً Operator * برای این Behavior استفاده میشود.
Matrix Multiplication
Matrix Multiplication یک Operation بنیادی است که Rowها و Columnها را با Dot Product ترکیب میکند. شرط Dimension داخلی باید برقرار باشد.
Forward Pass یک Linear Layer در Neural Network نمونهای مستقیم از ضرب Matrix است.
Transpose
Transpose Row و Column را جابهجا میکند. در فرمولهای Regression، Covariance و بسیاری از Derivationها ظاهر میشود.
Identity Matrix
Identity Matrix نقش عدد 1 را در ضرب Matrix دارد. ضرب Matrix سازگار در Identity Result اصلی را حفظ میکند.
Inverse Matrix
Inverse در برخی فرمولها ظاهر میشود، اما در Computation واقعی ساخت Explicit Inverse همیشه بهترین راه نیست. Solverهای عددی اغلب Stableتر و Efficientتر هستند.
Determinant
Determinant اطلاعاتی درباره Scale Transformation و Invertibility Matrix میدهد. Matrix با Determinant صفر Singular است.
Rank
Rank تعداد Dimensionهای مستقل Information در Matrix را نشان میدهد. Rank پایین میتواند به Redundancy میان Featureها اشاره کند.
Linear Independence
Vectorها زمانی مستقلاند که هیچکدام Combination خطی بقیه نباشد. این مفهوم برای Rank، Basis و Feature Redundancy مهم است.
Basis
Basis مجموعهای از Vectorهای مستقل است که Space را Span میکنند. تغییر Basis میتواند Representation داده را سادهتر کند.
Span
Span مجموعه تمام Combinationهای خطی Vectorهاست. در ML کمک میکند بفهمیم Model خطی چه Spaceای از Outputها را میتواند نمایش دهد.
Tensors
Tensor تعمیم Vector و Matrix به Dimensionهای بیشتر است. Image RGB، Video و Batchهای Deep Learning بهطور طبیعی Tensor هستند.
در Frameworkهای مدرن، بیشتر Parameterها و Activationها Tensor هستند.
NumPy Arrays
NumPy ابزار اصلی کتاب برای پیادهسازی Linear Algebra است. ndarray اجازه میدهد Vector، Matrix و Tensor را با Operationهای Efficient مدیریت کنیم.
Vectorization
Vectorization یعنی استفاده از Operationهای Array بهجای Loopهای Python. این روش معمولاً Code را کوتاهتر و سریعتر میکند.
Broadcasting
Broadcasting اجازه میدهد Arrayهایی با Shapeهای سازگار بدون Copy کامل با هم Operation انجام دهند. فهم Ruleهای آن برای جلوگیری از Bug ضروری است.
Matrix Decomposition
Decomposition یک Matrix پیچیده را به Factorهای سادهتر تقسیم میکند. این روشها برای Solver، Compression، Dimensionality Reduction و Numerical Stability اهمیت دارند.
LU Decomposition
LU Matrix را به Factorهای Lower و Upper triangular تقسیم میکند و برای حل Systemهای خطی مفید است.
QR Decomposition
QR Matrix را به Q با Columnهای orthonormal و R triangular تقسیم میکند. Least Squares یکی از کاربردهای مهم آن است.
Cholesky Decomposition
برای Matrixهای symmetric positive definite، Cholesky روش Efficient و Stableای برای Factorization فراهم میکند.
Eigenvalues و Eigenvectors
Eigenvector Directionی است که Transformation Matrix Direction آن را تغییر نمیدهد و فقط Scale میشود. Eigenvalue همان Scale را مشخص میکند.
این مفاهیم در PCA، Dynamical System و Spectral Methodها اهمیت دارند.
Eigendecomposition
در شرایط مناسب، Matrix را میتوان با Eigenvector و Eigenvalueها Decompose کرد. این Representation Structure درونی Transformation را آشکار میکند.
Singular Value Decomposition
SVD یکی از قدرتمندترین Decompositionهاست و برای Matrixهای عمومی کاربرد دارد. Matrix به U، Σ و V تقسیم میشود.
Singular Valueها اهمیت Directionهای مختلف را نشان میدهند و برای Low-rank Approximation بسیار مفیدند.
Low-rank Approximation
با نگه داشتن Singular Valueهای بزرگ میتوان Matrix را با Dimension کمتر Approximate کرد. این روش برای Compression، Noise Reduction و Recommendation کاربرد دارد.
Pseudoinverse
وقتی Matrix Square یا Invertible نیست، Moore-Penrose Pseudoinverse میتواند Solution Least Squares فراهم کند.
Least Squares
در Regression خطی، هدف اغلب Minimize کردن مجموع مربع Errorهاست. Linear Algebra راه مستقیم و ساختاریافتهای برای بیان این مسئله دارد.
Linear Regression
Model خطی Relation میان Featureها و Target را به شکل Weighted Sum نمایش میدهد. Matrix notation اجازه میدهد همه Sampleها یکجا نوشته شوند.
Normal Equation
Normal Equation یک Solution بسته برای Least Squares ارائه میکند، اما در Dataset بزرگ یا Matrix بدشرط، روشهای Numerical یا Iterative مناسبترند.
Covariance
Covariance نشان میدهد دو Variable چگونه با هم تغییر میکنند. Covariance Matrix Relation Pairwise میان Featureها را ثبت میکند.
Correlation
Correlation شکل Scale-normalized از رابطه خطی است. Correlation بالا به معنی Causality نیست.
Multivariate Statistics
وقتی چند Feature همزمان بررسی میشوند، Matrix زبان طبیعی Statistics چندمتغیره است. Mean Vector و Covariance Matrix دو ساختار پایه هستند.
Principal Component Analysis
PCA داده را به Directionهایی با Variance بیشتر Projection میکند. این Directionها Principal Components نام دارند.
PCA برای Visualization، Compression و کاهش Collinearity کاربرد دارد.
Centering
قبل از PCA معمولاً Mean هر Feature از داده کم میشود. بدون Centering، Componentها ممکن است Meaning مورد انتظار را نداشته باشند.
Scaling
اگر Featureها Unit و Scale بسیار متفاوت داشته باشند، Variance بزرگ یک Feature میتواند PCA را Dominant کند. Standardization در بسیاری از Contextها ضروری است.
PCA با Eigendecomposition
یکی از روشهای توضیح PCA استفاده از Eigenvectorهای Covariance Matrix است. Eigenvalue مقدار Variance توضیحدادهشده را نشان میدهد.
PCA با SVD
SVD معمولاً روش Numerical مستقیمتر و Stableتری برای محاسبه PCA روی Data Matrix فراهم میکند.
Dimensionality Reduction
کاهش Dimension میتواند Noise، Memory و هزینه Computation را کم کند. اما حذف Dimension ممکن است Information مهم را نیز از بین ببرد.
Sparse Matrices
در Text Mining و Recommendation، Matrix ممکن است بیشتر از صفرها تشکیل شده باشد. Sparse Representation Memory و Computation را کاهش میدهد.
Sparsity
Sparsity فقط ویژگی Storage نیست؛ در بعضی Modelها به Interpretability یا Feature Selection نیز مرتبط میشود.
Distance
Distance Metric تعیین میکند Similarity نمونهها چگونه اندازهگیری شود. Euclidean distance فقط یکی از گزینههاست و انتخاب Metric باید با Domain هماهنگ باشد.
Cosine Similarity
Cosine زاویه میان Vectorها را میسنجد و نسبت به Magnitude حساسیت کمتری دارد. در Text Vector و Embeddingها کاربرد فراوان دارد.
Projection
Projection یک Vector را روی Subspace نمایش میدهد. Least Squares و PCA هر دو Interpretation هندسی با Projection دارند.
Orthogonality
Vectorهای Orthogonal Dot Product صفر دارند. Basisهای orthonormal محاسبات را ساده و Numerically stableتر میکنند.
Geometric Interpretation
یکی از راههای فهم Linear Algebra دید هندسی است. Matrix میتواند Rotation، Scaling، Reflection یا Projection انجام دهد.
Gradient و Linear Algebra
Optimization در ML با Vector Gradient و Matrix Derivativeها بیان میشود. حتی اگر کتاب Calculus محور نباشد، فهم Shape Parameterها برای Gradient ضروری است.
Neural Networks
Linear Layer عملاً Matrix Multiplication بهعلاوه Bias است. Nonlinearity بعد از آن باعث میشود ترکیب Layerها Function پیچیده بسازد.
Batch Processing
بهجای پردازش یک نمونه، Batch به شکل Matrix وارد Model میشود. GPUها نیز برای عملیات Matrix/Tensor موازی بسیار مناسباند.
Machine Learning Pipelines
Normalization، Projection، Regression و بسیاری از Transformationها همه با Linear Algebra توصیف میشوند. فهم این زبان Debugging Pipeline را آسانتر میکند.
Numerical Precision
Floating-point دقیقاً مانند عدد حقیقی رفتار نمیکند. Matrix بدشرط میتواند Error کوچک را تقویت کند.
Condition Number
Condition Number حساسیت Solution به Error را نشان میدهد. مقدار بسیار بزرگ هشدار میدهد مسئله Numerical unstable است.
Stable Algorithms
دو فرمول mathematically equivalent ممکن است از نظر Numerical رفتار متفاوت داشته باشند. در Code باید روش Stable انتخاب شود.
Data Leakage
اگر PCA یا Scaling قبل از Split روی کل Dataset Fit شود، اطلاعات Test وارد Training میشود. Transformerهای Data باید فقط روی Train Fit شوند.
Feature Engineering
Linear Combination و Projection ابزارهای مهم Feature Engineering هستند. حتی Modelهای Deep نیز از همان Operationهای پایه استفاده میکنند.
Interpretability
Weight یک Model خطی در Context Scale و Correlation Featureها تفسیر میشود. مقدار بزرگ یک Coefficient بهتنهایی اهمیت Cause را ثابت نمیکند.
کار با Python
ارزش عملی کتاب در این است که هر Concept میتواند با NumPy آزمایش شود. ساخت Array، reshape، dot، transpose و decomposition Skillهای پایه هستند.
تمرین پیشنهادی
یک Dataset کوچک بسازید، Mean و Covariance را محاسبه کنید، PCA را اجرا و Projection دوبعدی رسم کنید. سپس Result را با Library آماده مقایسه کنید.
اشتباهات رایج
- اشتباه گرفتن Element-wise multiplication با Matrix Multiplication.
- نادیده گرفتن Shape.
- استفاده مستقیم از Inverse بهجای Solver مناسب.
- Fit کردن PCA روی کل Dataset.
- تفسیر Correlation بهعنوان Causality.
پیشنیازها
آشنایی پایه با Python و Arithmetic کافی است، اما دانستن Algebra و مفهوم Function مطالعه را آسانتر میکند. تمرکز کتاب بر Practical Linear Algebra است، نه Proofهای انتزاعی.
برای چه کسانی مناسب است؟
- دانشجویان Machine Learning و Data Science.
- برنامهنویسان Python که میخواهند ریاضی پشت Modelها را بفهمند.
- افرادی که در NumPy با Shape و Matrix Operation مشکل دارند.
- دانشجویانی که قصد یادگیری PCA و SVD دارند.
- توسعهدهندگانی که میخواهند از حفظ Formula به درک ساختاری برسند.
جمعبندی
Basics of Linear Algebra for Machine Learning اثر Jason Brownlee یک مقدمه کاربردی بر زبان ریاضی داده است. Vector، Matrix، Tensor، Matrix Decomposition، Eigenvalue، SVD، Statistics چندمتغیره، PCA و Linear Regression در این مسیر بهصورت مرتبط با Machine Learning بررسی میشوند.
ارزش اصلی اثر در پیوند Theory و Python است. وقتی خواننده بتواند Operationها را با NumPy اجرا و Shape و Interpretation هندسی آنها را بفهمد، بسیاری از Algorithmهای ML از حالت جعبه سیاه خارج میشوند. این کتاب برای ساخت پایهای عملی مناسب است و میتواند مقدمهای برای مطالعه عمیقتر Linear Algebra، Optimization و Statistical Learning باشد.




نقد و بررسیها
هنوز بررسیای ثبت نشده است.