
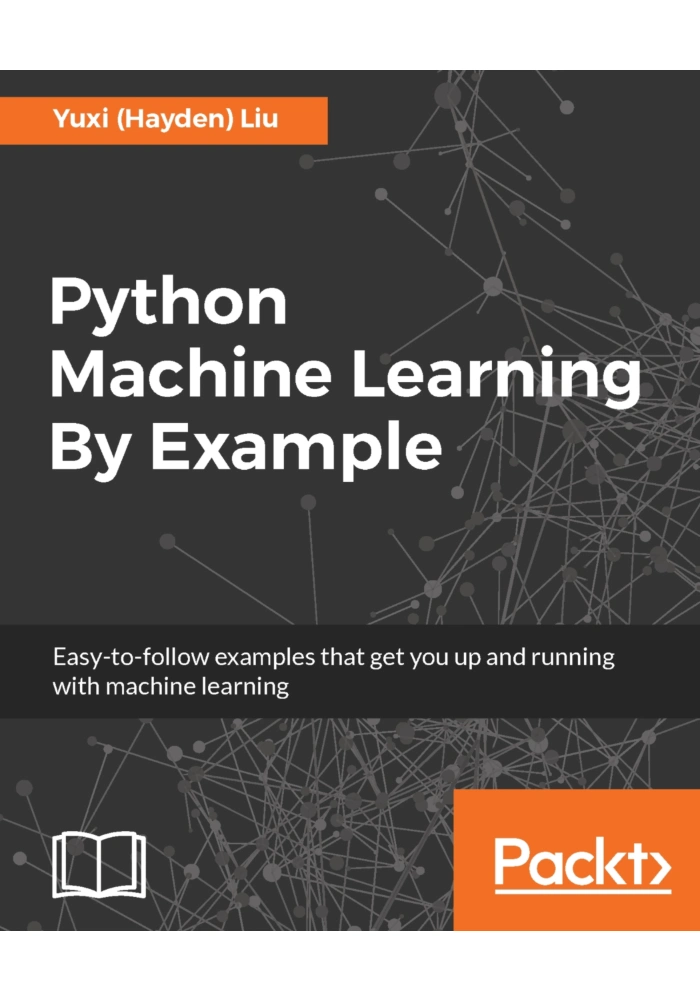

کتاب یادگیری ماشین با پایتون اثر یوکسی لیو نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 249 صفحه
- حجم فایل: 4.95 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب Python Machine Learning By Example
Python Machine Learning By Example یک منبع پروژهمحور برای یادگیری یادگیری ماشین با Python است که خواننده را از مفاهیم پایه به سمت حل مسئلههای واقعی هدایت میکند. رویکرد کتاب بر این ایده استوار است که Machine Learning زمانی بهتر فهمیده میشود که الگوریتمها فقط در قالب تعریف و فرمول باقی نمانند و روی داده واقعی، با مراحل آمادهسازی، آموزش، ارزیابی و بهبود مدل اجرا شوند. فایل این محصول به زبان انگلیسی ثبت شده و عنوان آن با اثر Yuxi (Hayden) Liu در مجموعه Packt همخوانی دارد.
یادگیری ماشین فقط انتخاب یک Algorithm و اجرای چند خط کد نیست. نتیجه قابل اعتماد زمانی به دست میآید که مسئله درست تعریف شود، داده تمیز و نماینده باشد، Featureها با دقت انتخاب شوند، معیار ارزیابی با هدف کسبوکار یا پژوهش هماهنگ باشد و مدل روی دادهای ارزیابی شود که در Training ندیده است. این کتاب برای ساخت همین طرز فکر عملی ارزشمند است.
Machine Learning چیست؟
Machine Learning مجموعهای از روشهاست که به سیستم اجازه میدهد Patternهای موجود در Data را یاد بگیرد و برای نمونههای جدید Prediction یا Decision تولید کند. بهجای نوشتن Rule جداگانه برای همه حالتها، Algorithm از Exampleها رابطه میان Input و Output را تخمین میزند.
کیفیت این یادگیری به Data، Representation و Evaluation وابسته است. Model قدرتمند روی داده نامناسب الزاماً خروجی خوب تولید نمیکند.
رویکرد یادگیری با مثال
مزیت اصلی یک کتاب Example-based این است که مراحل واقعی پروژه را کنار هم نشان میدهد. Reader فقط Logistic Regression یا Decision Tree را جداگانه نمیبیند؛ بلکه میآموزد چگونه Dataset را Load کند، Featureها را بسازد، Data را Split کند، Model را Train کند و Result را تفسیر کند.
این Workflow همان چیزی است که در پروژههای Data Science و Machine Learning تکرار میشود.
تعریف مسئله
پیش از انتخاب Model باید سؤال روشن باشد. آیا هدف Classification است، Regression، Recommendation، Ranking یا Clustering؟ تعریف مبهم مسئله باعث میشود Metric و Data نیز اشتباه انتخاب شوند.
گاهی بهتر است یک مسئله بزرگ به چند مسئله کوچکتر تبدیل شود. برای مثال ابتدا Detection انجام شود و سپس Classification روی موارد تشخیصدادهشده اجرا شود.
Supervised Learning
در Supervised Learning هر Training Example دارای Input و Label یا Target است. Model تلاش میکند Mapping میان آنها را یاد بگیرد.
Classification برای Target دستهای و Regression برای Target عددی از مهمترین Taskهای این حوزه هستند.
Unsupervised Learning
در Unsupervised Learning Label مستقیم وجود ندارد و هدف کشف Structure در Data است. Clustering و Dimensionality Reduction نمونههای شناختهشدهاند.
Evaluation در این حوزه دشوارتر است، زیرا همیشه Ground Truth روشنی وجود ندارد.
داده مهمتر از الگوریتم
یکی از درسهای مهم در Machine Learning این است که Data Quality معمولاً اثر بسیار زیادی روی نتیجه دارد. Missing Value، Duplicate، Label اشتباه و Distribution نامتناسب میتوانند Model را گمراه کنند.
پیش از Training باید Data Profiling انجام شود و مشخص شود هر Column چه معنایی دارد.
Data Cleaning
تمیزکردن داده شامل مدیریت Missing Value، Formatهای ناسازگار، Outlierهای مشکوک و Duplicateهاست. حذف خودکار هر مورد غیرعادی تصمیم خوبی نیست؛ ابتدا باید دلیل آن بررسی شود.
گاهی Outlier Error است و گاهی مهمترین Observation Dataset.
Train و Test
برای ارزیابی Generalization باید بخشی از Data از Training جدا بماند. Test Set باید تا مرحله نهایی دستنخورده حفظ شود.
اگر Model بارها بر اساس Test Result تغییر کند، Test Set عملاً به Validation Set تبدیل میشود و Estimate نهایی خوشبینانه خواهد بود.
Validation
Validation برای انتخاب Hyperparameter، Feature و Model استفاده میشود. Cross-Validation زمانی مفید است که Dataset محدود باشد و بخواهیم Performance را روی چند Split بررسی کنیم.
Data Leakage
Leakage زمانی رخ میدهد که اطلاعاتی از آینده یا Test Data به Training وارد شود. این مشکل میتواند Accuracy بسیار بالا اما غیرواقعی ایجاد کند.
Normalization، Feature Selection و Imputation باید با رعایت Split انجام شوند.
Feature Engineering
Feature Representation مشخص میکند Model چه اطلاعاتی در اختیار دارد. در بسیاری از پروژههای کلاسیک، Feature Engineering از انتخاب Algorithm مهمتر است.
Feature باید مرتبط، قابل محاسبه در زمان Prediction و تا حد امکان پایدار باشد.
Categorical Features
داده دستهای معمولاً باید به Representation عددی تبدیل شود. روش Encoding به نوع Category و Model بستگی دارد.
برای Categoryهای جدید در Production نیز باید Strategy مشخصی وجود داشته باشد.
Scaling
بعضی Algorithmها مانند روشهای مبتنی بر Distance یا Gradient به Scale Featureها حساس هستند. Standardization یا Normalization میتواند Training را پایدارتر کند.
Tree-based Modelها معمولاً حساسیت کمتری به Scale دارند.
Classification
در Classification هدف پیشبینی Label است. Spam Detection، Sentiment، Churn و تشخیص نوع Object نمونههایی از این مسئله هستند.
Accuracy فقط یکی از Metricهاست و برای Dataset نامتوازن ممکن است گمراهکننده باشد.
Logistic Regression
Logistic Regression یکی از Modelهای پایه Classification است که Probability Outcome دودویی را تخمین میزند. سادگی و Interpretability آن باعث شده هنوز در بسیاری از پروژهها Baseline خوبی باشد.
Naive Bayes
Naive Bayes بر فرض سادهای درباره Independence Featureها متکی است، اما در Text Classification میتواند عملکرد قابل توجهی داشته باشد.
سرعت Training و Prediction یکی از مزایای آن است.
Decision Tree
Decision Tree Data را با مجموعهای از Splitها تقسیم میکند. مسیر تصمیم برای انسان قابل مشاهده است، اما Tree عمیق میتواند Overfit شود.
کنترل Depth و Minimum Samples از روشهای Regularization آن هستند.
Random Forest
Random Forest چند Tree را با Randomness در Data و Feature ترکیب میکند. Ensemble باعث کاهش Variance نسبت به یک Tree منفرد میشود.
Feature Importance میتواند Insight اولیه بدهد، اما تفسیر آن باید با احتیاط انجام شود.
Support Vector Machine
SVM تلاش میکند Boundary با Margin مناسب میان Classها پیدا کند. Kernel اجازه میدهد Relation غیرخطی در Space جدید مدل شود.
Scaling Feature و انتخاب Parameterها روی عملکرد آن اثر زیادی دارد.
k-Nearest Neighbors
KNN Prediction را بر اساس Sampleهای نزدیک انجام میدهد. Training آن ساده است، اما Prediction روی Dataset بزرگ میتواند پرهزینه باشد.
Distance Metric و Scale Featureها بسیار مهم هستند.
Regression
در Regression Target عددی است. پیشبینی Price، Demand، Duration یا مقدار Continuous نمونههایی از آن هستند.
MAE، MSE و RMSE Metricهای رایجاند و هرکدام Error را به شکل متفاوتی وزن میدهند.
Linear Regression
Linear Regression رابطه Target و Featureها را با ترکیب خطی مدل میکند. با وجود سادگی، Baseline بسیار مهمی است.
Residual Analysis میتواند نشان دهد Assumption خطی مناسب است یا نه.
Regularization
Regularization Complexity Model را محدود میکند تا Overfitting کاهش یابد. L1 و L2 دو روش شناختهشده هستند.
L1 میتواند بعضی Coefficientها را به صفر نزدیک کند و در Feature Selection نیز نقش داشته باشد.
Overfitting
Overfitting زمانی رخ میدهد که Model Noise و جزئیات Training Set را یاد بگیرد. Training Score بالا اما Validation ضعیف نشانه رایجی است.
Data بیشتر، Regularization، Feature مناسب و Model سادهتر میتوانند کمک کنند.
Underfitting
Model خیلی ساده ممکن است حتی Pattern اصلی Training Data را نیز یاد نگیرد. در این حالت هم Training و هم Validation Performance پایین هستند.
Bias و Variance
Bias-Variance Trade-off چارچوب خوبی برای فهم Underfitting و Overfitting است. Model ساده Bias بالا و Model بسیار انعطافپذیر Variance بالا دارد.
Ensemble Learning
Ensemble چند Model را ترکیب میکند تا Prediction پایدارتر شود. Bagging و Boosting دو خانواده مهماند.
ترکیب Modelها زمانی ارزش دارد که Errorهای آنها کاملاً یکسان نباشد.
Boosting
Boosting Modelها را به شکل ترتیبی میسازد و روی Exampleهایی که قبلاً دشوار بودهاند تمرکز بیشتری میکند.
Gradient Boosting یکی از روشهای قدرتمند برای داده جدولی است.
Clustering
Clustering Sampleهای مشابه را بدون Label در Group قرار میدهد. کاربردهای آن شامل Segmentation مشتری، تحلیل رفتار و اکتشاف داده است.
k-Means
k-Means Clusterها را بر اساس Distance از Centroid میسازد. انتخاب تعداد Cluster و Scaling Featureها اهمیت زیادی دارد.
این Algorithm برای Shapeهای پیچیده Cluster همیشه مناسب نیست.
Dimensionality Reduction
در Dataset با Feature زیاد میتوان Representation کوچکتری ساخت. PCA یکی از روشهای کلاسیک است.
کاهش Dimension میتواند Visualization، Noise Reduction و Efficiency را بهبود دهد.
PCA
PCA جهتهایی را پیدا میکند که بیشترین Variance Data را توضیح میدهند. Componentها ترکیب خطی Featureهای اصلی هستند.
Standardization پیش از PCA در بسیاری از Datasetها لازم است.
Text Classification
Text باید به Feature عددی تبدیل شود. Bag-of-Words و TF-IDF از Representationهای کلاسیک هستند.
Cleaning بیش از حد Text میتواند اطلاعات مفید را حذف کند، بنابراین هر Step باید با Task هماهنگ باشد.
TF-IDF
TF-IDF Termهایی را برجسته میکند که در Document مهماند اما در کل Corpus بیش از حد رایج نیستند.
این روش هنوز برای Baselineهای Text بسیار مفید است.
Recommendation Systems
Recommendation هدفش پیشنهاد Item مرتبط به User است. Collaborative Filtering و Content-based دو رویکرد اصلی کلاسیک هستند.
Cold Start یکی از چالشهای مهم برای User یا Item جدید است.
Collaborative Filtering
این روش از الگوی تعامل Userها و Itemها استفاده میکند. Similarity میان Userها یا Itemها میتواند مبنای Recommendation باشد.
Evaluation سیستم توصیهگر
Accuracy ساده کافی نیست. Ranking Metric، Diversity، Coverage و حتی Business Outcome میتوانند اهمیت داشته باشند.
Imbalanced Data
اگر Class مثبت بسیار نادر باشد، Model میتواند با پیشبینی دائمی Class اکثریت Accuracy بالا بگیرد. Precision، Recall و PR Curve در این شرایط مفیدترند.
Confusion Matrix
Confusion Matrix تعداد True Positive، False Positive، True Negative و False Negative را نشان میدهد.
این Matrix کمک میکند نوع Errorها جداگانه دیده شوند.
Precision و Recall
Precision میگوید از Predictionهای مثبت چند مورد درستاند و Recall میگوید از Positiveهای واقعی چند مورد پیدا شدهاند.
Threshold تصمیم میتواند Trade-off میان این دو را تغییر دهد.
F1 Score
F1 میانگین Harmonic Precision و Recall است و زمانی مفید است که هر دو اهمیت دارند.
ROC-AUC
ROC-AUC توانایی Ranking Model در Thresholdهای مختلف را خلاصه میکند. برای داده بسیار نامتوازن باید همراه Metricهای دیگر بررسی شود.
Hyperparameter Tuning
Hyperparameter پیش از Training تعیین میشود؛ مانند Depth Tree یا Strength Regularization. انتخاب آن باید روی Validation انجام شود.
Grid Search
Grid Search مجموعهای از Combinationها را امتحان میکند. ساده است اما با افزایش Dimension بسیار پرهزینه میشود.
Random Search
Random Search در بسیاری از Spaceها با Budget مساوی Efficientتر از Grid است، زیرا Parameterهای بیشتری را در Rangeهای متنوع بررسی میکند.
Pipeline
Pipeline Preprocessing و Model را در یک Workflow واحد قرار میدهد. این کار از Leakage جلوگیری و Deployment را سادهتر میکند.
Reproducibility
Random Seed، Data Version، Feature Code و Parameterها باید ثبت شوند. بدون این اطلاعات Result قابل تکرار نیست.
Model Persistence
پس از Training ممکن است Model برای استفاده بعدی ذخیره شود. Version Library و Feature Pipeline باید همراه آن مدیریت شوند.
Prediction در Production
Model خوب در Notebook لزوماً Production-ready نیست. Latency، Memory، Error Handling و Data Schema باید در محیط واقعی بررسی شوند.
Training-Serving Skew
اگر Feature در Training و Production با Logic متفاوت محاسبه شود، Model Performance افت میکند. یک Pipeline مشترک ریسک این مشکل را کاهش میدهد.
Data Drift
Distribution داده در طول زمان ممکن است تغییر کند. Monitoring باید مشخص کند آیا Input یا Performance Model از حالت Training فاصله گرفته است.
Concept Drift
گاهی رابطه میان Feature و Target تغییر میکند. در این حالت حتی اگر Distribution Input ثابت باشد، Model قدیمی میتواند ضعیف شود.
Baseline
قبل از Model پیچیده باید Baseline ساده ساخته شود. اگر Algorithm پیشرفته از Baseline بهتر نیست، Complexity اضافه توجیه ندارد.
تفسیر مدل
در بعضی کاربردها فقط Prediction کافی نیست و باید دلیل Decision فهمیده شود. Coefficient، Feature Importance و ابزارهای Explainability میتوانند کمک کنند.
Correlation و Causation
Machine Learning عمدتاً Pattern پیشبینی را یاد میگیرد. Prediction خوب به معنی اثبات رابطه علّی نیست.
Ethics
Bias داده میتواند روی گروههای مختلف اثر نابرابر داشته باشد. Evaluation باید فقط Average Score را نبیند و در صورت مرتبط بودن Performance گروهها را نیز بررسی کند.
Privacy
جمعآوری Feature باید با نیاز پروژه متناسب باشد. داده حساس نباید صرفاً چون قابل دسترسی است وارد Model شود.
امنیت مدل و داده
Dataset، Model Artifact و API Prediction باید مانند Assetهای نرمافزاری دیگر محافظت شوند. Secretها نباید در Notebook یا Source Code ذخیره شوند.
نسخه تاریخی ابزارها
کتاب مربوط به نسل قدیمیتر اکوسیستم Python Machine Learning است. API کتابخانههایی مانند scikit-learn، pandas و سایر ابزارها از زمان انتشار تغییر کردهاند.
بهتر است Concept و Workflow از کتاب یاد گرفته شود و Syntax نهایی با Documentation نسخه فعلی تطبیق داده شود.
روش مطالعه پیشنهادی
هر Example را یک بار همانطور که ارائه شده اجرا کنید و سپس Dataset یا Parameter را تغییر دهید. هدف فقط گرفتن همان Output نیست؛ باید بفهمید چرا Result تغییر میکند.
برای هر پروژه یک Baseline بسازید، Metric را پیش از Tuning مشخص کنید و Result Train و Validation را کنار هم گزارش دهید.
این کتاب برای چه کسانی مناسب است؟
- برنامهنویسان Python که میخواهند وارد Machine Learning شوند.
- دانشجویان Data Science و علوم کامپیوتر.
- افرادی که آموزش پروژهمحور را به مطالعه صرفاً نظری ترجیح میدهند.
- تحلیلگرانی که میخواهند مدلهای کلاسیک را روی داده واقعی پیاده کنند.
- افرادی که به دنبال درک Workflow کامل از Data تا Evaluation هستند.
جمعبندی
Python Machine Learning By Example مسیری عملی برای یادگیری Machine Learning با Python ارائه میدهد. Classification، Regression، Clustering، Text Processing، Recommendation، Ensemble، Feature Engineering و Evaluation در قالب مسئلههای واقعی معنا پیدا میکنند.
مهمترین ارزش این کتاب ساختن یک Workflow صحیح است: مسئله را تعریف کنید، Data را بررسی کنید، Baseline بسازید، Split درست انجام دهید، Model را فقط روی Training آموزش دهید و نتیجه را با Metric مناسب روی داده ندیده بسنجید. این عادتها مستقل از Version کتابخانهها و Algorithm خاص، پایه کار حرفهای در یادگیری ماشین هستند.




نقد و بررسیها
هنوز بررسیای ثبت نشده است.