
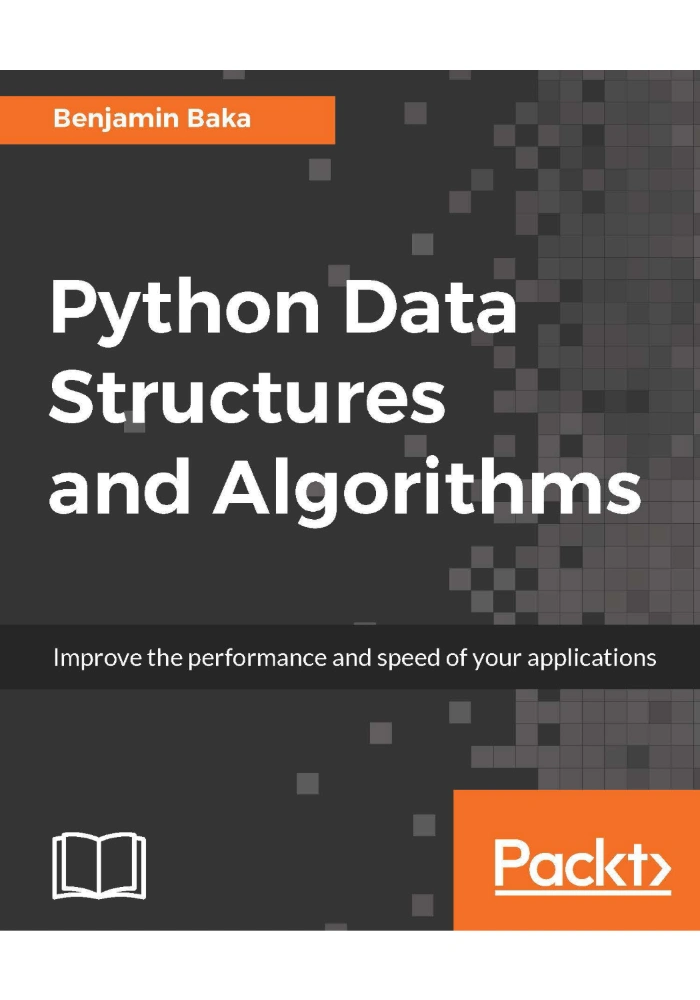

کتاب ساختار داده و الگوریتم با پایتون اثر بنجامین باکا نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 304 صفحه
- حجم فایل: 11.57 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب Python Data Structures and Algorithms اثر Benjamin Baka
Python Data Structures and Algorithms اثر Benjamin Baka یک منبع آموزشی برای درک ساختمان دادهها، الگوریتمها و روش حل مسئله با زبان Python است. این کتاب برای خوانندهای مناسب است که مبانی برنامهنویسی را میداند و میخواهد بفهمد انتخاب ساختار داده یا الگوریتم مناسب چگونه بر سرعت، مصرف حافظه، خوانایی و مقیاسپذیری برنامه اثر میگذارد. فایل موجود در این محصول به زبان انگلیسی است و عنوان و نام نویسنده آن با نسخه منتشرشده توسط Packt همخوانی دارد.
ساختمان داده فقط موضوعی دانشگاهی نیست. تقریباً هر برنامه واقعی مجموعهای از دادهها را ذخیره، جستوجو، مرتب، حذف یا بهروزرسانی میکند. اگر این عملیات با ساختار نامناسب انجام شوند، برنامهای که روی صد رکورد سریع است ممکن است روی یک میلیون رکورد بسیار کند شود. مطالعه این کتاب کمک میکند تصمیمهای مهندسی درباره List، Stack، Queue، Tree، Graph، Hash Table و الگوریتمهای مرتبط آگاهانهتر شوند.
ساختمان داده چیست؟
Data Structure روشی برای سازماندهی و نگهداری داده است تا عملیات موردنیاز با هزینه مناسب انجام شوند. هیچ Structure برای همه مسئلهها بهترین نیست. انتخاب مناسب به نوع Access، تعداد Insert و Delete، نیاز به Ordering و محدودیت Memory بستگی دارد.
به همین دلیل یادگیری ساختمان داده باید همراه با Complexity باشد. دانستن نحوه ساخت یک Structure بدون دانستن هزینه عملیات آن تصویر ناقصی ایجاد میکند.
الگوریتم چیست؟
Algorithm مجموعهای از Stepهای مشخص برای حل مسئله است. دو Algorithm ممکن است خروجی یکسان تولید کنند اما زمان یا حافظه بسیار متفاوتی مصرف کنند.
هدف تحلیل الگوریتم پیدا کردن رفتار آن با بزرگ شدن Input است، نه فقط اندازهگیری زمان روی یک مثال کوچک.
Big-O و تحلیل Complexity
Big-O نرخ رشد هزینه Algorithm را بیان میکند. O(1)، O(log n)، O(n)، O(n log n) و O(n²) از Complexityهای رایج هستند.
این Notation زمان دقیق را مشخص نمیکند، اما برای مقایسه Scalability روشها بسیار مفید است.
Time Complexity
Time Complexity نشان میدهد تعداد عملیات با افزایش Input چگونه رشد میکند. یک Loop ساده اغلب O(n) و دو Loop تو در تو روی همان Data ممکن است O(n²) باشند.
البته Structure الگوریتم مهمتر از ظاهر کد است؛ دو Loop همیشه به معنی O(n²) نیستند.
Space Complexity
بعضی Algorithmها برای سرعت بیشتر Memory بیشتری مصرف میکنند. Cache کردن نتیجه یا ساخت Hash Table نمونههایی از این Trade-off هستند.
در سیستمهای محدود یا Data بسیار بزرگ، Space Complexity اهمیت زیادی دارد.
List در Python
List یکی از پرکاربردترین Containerهای Python است. Access بر اساس Index سریع است و Append معمولاً هزینه مناسبی دارد.
اما Insert یا Delete در ابتدای List میتواند نیازمند جابهجایی تعداد زیادی Element باشد. بنابراین List برای همه نوع Queue بهترین انتخاب نیست.
Dynamic Array
List پایتون از نظر Conceptual به Dynamic Array نزدیک است. ظرفیت داخلی آن میتواند بیش از Size فعلی باشد تا Appendهای متوالی نیازمند Allocation دائمی نباشند.
این رفتار نمونه خوبی از Amortized Complexity است.
Tuple
Tuple Sequence غیرقابلتغییر است. برای دادهای که پس از ساخت نباید تغییر کند، میتواند Intent روشنتری نسبت به List داشته باشد.
Immutability همچنین امکان Hashable بودن بعضی Tupleها را فراهم میکند.
Dictionary
Dictionary نگاشت Key به Value است و یکی از مهمترین Data Structureهای Python محسوب میشود. Lookup، Insert و Update در شرایط معمول بسیار سریع هستند.
کاربردهایی مانند Index، Cache، Frequency Count و Configuration بهخوبی با Dictionary مدل میشوند.
Hash Table
Dictionary بر مفهوم Hashing تکیه دارد. Hash Function Key را به Position یا Bucket داخلی مرتبط میکند.
Collision زمانی رخ میدهد که Keyهای مختلف به Location مشابه برسند. Implementation باید این وضعیت را مدیریت کند.
Set
Set مجموعهای از Elementهای Unique است. Membership Test یکی از کاربردهای مهم آن است.
اگر هدف فقط بررسی وجود یک Value باشد، Set معمولاً از Search خطی در List مناسبتر است.
Stack
Stack از الگوی Last In, First Out پیروی میکند. Call Stack، Undo و DFS نمونههایی از کاربردهای آن هستند.
در Python میتوان برای بسیاری از Stackهای ساده از List استفاده کرد.
Queue
Queue از الگوی First In, First Out پیروی میکند. Scheduling، BFS و Buffering مثالهای رایجاند.
برای حذف مکرر از ابتدای Sequence بهتر است Structure مناسب Queue استفاده شود تا جابهجایی غیرضروری کاهش یابد.
Deque
Double-ended Queue اجازه Insert و Delete مؤثر از هر دو سمت را میدهد. برای Queue و Sliding Window انتخاب مناسبی است.
Linked List
Linked List Elementها را بهصورت Nodeهای متصل نگه میدارد. Insert و Delete در Position شناختهشده میتواند ساده باشد، اما Random Access سریع ندارد.
در Python عملی، List داخلی اغلب به دلیل Cache Locality و Implementation بهینه انتخاب بهتری است؛ با این حال Linked List برای فهم Structure و Algorithm اهمیت آموزشی بالایی دارد.
Singly Linked List
هر Node در Singly Linked List به Node بعدی اشاره میکند. Traversal فقط در یک جهت انجام میشود.
حذف یا Insert نیازمند مدیریت دقیق Referenceهاست.
Doubly Linked List
در Doubly Linked List هر Node معمولاً به Node قبلی و بعدی اشاره دارد. Traversal دوطرفه آسانتر میشود اما Memory بیشتری مصرف میشود.
Tree
Tree برای نمایش ساختار Hierarchical مناسب است. File System، DOM، سازمانها و Expression Tree نمونههایی از کاربرد هستند.
Root، Parent، Child، Leaf و Height از اصطلاحات پایهاند.
Binary Tree
در Binary Tree هر Node حداکثر دو Child دارد. این Structure پایه بسیاری از Algorithmهای Tree است.
Binary Search Tree
BST Property مشخصی برای Ordering دارد؛ معمولاً Valueهای کوچکتر در یک سمت و بزرگتر در سمت دیگر قرار میگیرند.
در حالت متوازن Search نزدیک O(log n) است، اما Tree نامتوازن میتواند به List خطی شبیه شود و O(n) شود.
Tree Traversal
Preorder، Inorder و Postorder سه Traversal کلاسیک هستند. انتخاب آنها به هدف مسئله بستگی دارد.
Traversal میتواند Recursive یا Iterative پیادهسازی شود.
Balanced Trees
هدف Treeهای متوازن کنترل Height است تا Search، Insert و Delete قابل پیشبینیتر بمانند.
در Libraryهای سطح بالا ممکن است توسعهدهنده مستقیماً این Structureها را پیاده نکند، اما فهم آنها برای Database Index و Runtimeها مفید است.
Heap
Heap Structureای برای مدیریت Priority است. در Min-Heap کوچکترین Element در Root قرار دارد.
Priority Queue، Scheduling و پیدا کردن Top-k از کاربردهای مهم Heap هستند.
Priority Queue
در Priority Queue ترتیب خروج بر اساس Priority است، نه زمان ورود. Job Scheduler و Algorithmهای Graph مانند Dijkstra از آن استفاده میکنند.
Graph
Graph مجموعه Vertex و Edge است و برای مدلسازی Network، Route، Dependency، Friendship و بسیاری از Relationها استفاده میشود.
Graph میتواند Directed یا Undirected و Weighted یا Unweighted باشد.
Adjacency List
Adjacency List برای هر Vertex همسایهها را نگه میدارد. برای Graph Sparse معمولاً Memory مناسبی دارد.
Adjacency Matrix
Adjacency Matrix ارتباط هر Pair از Vertexها را در Matrix نگه میدارد. Lookup مستقیم Edge ساده است، اما برای Graph بزرگ و Sparse Memory زیادی مصرف میکند.
Breadth-First Search
BFS با Queue سطحبهسطح Graph را پیمایش میکند. در Graph بدون Weight، Shortest Path از نظر تعداد Edge را پیدا میکند.
Visited Set برای جلوگیری از Loop و پردازش تکراری ضروری است.
Depth-First Search
DFS مسیر را تا عمق ادامه میدهد و سپس Backtrack میکند. برای Cycle Detection، Componentها و Traversal Structure مفید است.
نسخه Recursive ساده است اما برای Graph بسیار عمیق محدودیت Stack میتواند مهم باشد.
Shortest Path
الگوریتم مناسب Shortest Path به نوع Weight بستگی دارد. BFS برای Graph بدون Weight و Dijkstra برای Weight غیرمنفی کاربرد دارد.
انتخاب روش بدون توجه به Constraint ممکن است نتیجه اشتباه ایجاد کند.
Dijkstra
Dijkstra Distance کوتاهترین مسیر از Source را با انتخاب Nodeهای نزدیکتر توسعه میدهد. Priority Queue Performance آن را بهبود میدهد.
Edge منفی با Assumption این Algorithm سازگار نیست.
Sorting
مرتبسازی پایه بسیاری از عملیات دیگر است. Search، Merge و Presentation داده پس از Sort سادهتر میشوند.
Python Algorithmهای Sort بهینه داخلی دارد؛ با این حال یادگیری Sortingهای کلاسیک برای فهم Complexity مفید است.
Bubble Sort
Bubble Sort آموزشی و ساده است، اما O(n²) دارد و برای Data بزرگ مناسب نیست.
ارزش آن بیشتر در فهم Comparison و Swap است.
Insertion Sort
Insertion Sort برای Dataset کوچک یا تقریباً مرتب میتواند مناسب باشد. Worst-case آن O(n²) است.
Selection Sort
Selection Sort در هر مرحله کوچکترین Element باقیمانده را پیدا میکند. ساده است اما Complexity زمانی ضعیفی دارد.
Merge Sort
Merge Sort از Divide and Conquer استفاده میکند و زمان O(n log n) دارد. برای Merge نیازمند فضای اضافی است.
Stable بودن آن در بعضی کاربردها مزیت است.
Quick Sort
Quick Sort با Pivot Data را Partition میکند. Average Performance آن خوب است اما Worst-case میتواند O(n²) باشد.
Pivot Selection روی رفتار واقعی اثر زیادی دارد.
Searching
Linear Search روی Data نامرتب ساده است و O(n) هزینه دارد. اگر Data مرتب باشد Binary Search میتواند بسیار سریعتر باشد.
Binary Search
Binary Search هر بار نیمی از Search Space را حذف میکند و Complexity آن O(log n) است.
شرط اساسی آن مرتب بودن Data است.
Recursion
Recursion زمانی طبیعی است که مسئله ساختار Self-similar داشته باشد. Tree Traversal و Divide and Conquer نمونههای خوبی هستند.
Base Case باید روشن باشد تا Recursion بینهایت رخ ندهد.
Dynamic Programming
Dynamic Programming برای مسئلههایی مفید است که Subproblemهای تکراری دارند. ذخیره Result از محاسبه مجدد جلوگیری میکند.
Memoization و Tabulation دو رویکرد رایجاند.
Memoization
در Memoization Result Function برای Inputهای قبلی Cache میشود. این روش میتواند Algorithm نمایی را در بعضی مسائل به نسخه بسیار سریعتر تبدیل کند.
Greedy Algorithms
Greedy در هر مرحله بهترین انتخاب محلی را انجام میدهد. این روش فقط زمانی Solution بهینه میدهد که Structure مسئله اجازه دهد.
بنابراین شهودی بودن Greedy جای اثبات Correctness را نمیگیرد.
Divide and Conquer
مسئله به Subproblemهای مستقل تقسیم میشود، آنها حل و Result ترکیب میشود. Merge Sort نمونه کلاسیک است.
Backtracking
Backtracking Solution را مرحلهبهمرحله میسازد و وقتی مسیر نامعتبر شد به عقب برمیگردد. Sudoku، N-Queens و Search ترکیبی مثالهای آموزشی هستند.
Hashing در حل مسئله
بسیاری از مسئلههای Interview یا Processing با تبدیل Search خطی به Lookup در Dictionary یا Set سادهتر و سریعتر میشوند.
اما هزینه Memory اضافی باید در نظر گرفته شود.
Frequency Counting
شمارش تکرار Valueها یکی از Patternهای رایج است. Dictionary یا Counter-like Structure برای این کار مناسب است.
Two-Pointer Technique
روی Sequence مرتب یا مسئلههای محدودهای میتوان از دو Pointer برای کاهش Loopهای تو در تو استفاده کرد.
این Pattern مثال خوبی از اهمیت ساختار مسئله در Complexity است.
Sliding Window
Sliding Window برای زیرآرایه یا Substring پیوسته کاربرد دارد. بهجای محاسبه مجدد کل Window، State هنگام حرکت Update میشود.
Top-k Problems
برای پیدا کردن چند Element بزرگ یا کوچک الزاماً نیازی به Sort کامل نیست. Heap یا Selection Algorithm میتواند Efficientتر باشد.
String Algorithms
String خود Sequence است و مسئلههایی مانند Search، Prefix، Frequency و Pattern Matching روی آن اعمال میشوند.
Encoding و Unicode در پروژه واقعی باید در نظر گرفته شوند.
Complexity عملیات Python
دانستن Complexity Built-inها مهم است. عضویت در List و Set رفتار متفاوت دارد؛ Append List با Insert ابتدا نیز یکسان نیست.
استفاده از Syntax کوتاه همیشه به معنی Algorithm سریع نیست.
Pythonic Code
هدف فقط کوتاه کردن کد نیست. Pythonic Code باید خوانا، قابل نگهداری و متکی بر Abstractionهای استاندارد باشد.
Built-inها و Libraryهای استاندارد معمولاً بهتر از بازسازی دستی Structureهای آمادهاند.
Iterator و Generator
Iterator اجازه پردازش Sequence بدون نگهداری همه Data در Memory را میدهد. Generator برای Pipelineهای داده بزرگ مفید است.
این موضوع Space Complexity را در عمل کاهش میدهد.
Memory Efficiency
برای Data بزرگ، Representation اهمیت دارد. List کامل از میلیونها Object میتواند Memory زیادی مصرف کند.
Streaming، Generator و Data Structure مناسب میتوانند مصرف RAM را کنترل کنند.
Algorithm Correctness
Algorithm سریع اما غلط هیچ ارزشی ندارد. ابتدا Correctness و Edge Caseها باید بررسی شوند.
سپس Optimization بر اساس Measurement انجام شود.
Edge Cases
Empty Input، یک Element، Duplicate، Negative Value و Data بسیار بزرگ نمونههایی هستند که باید تست شوند.
بسیاری از Bugها در همین Boundaryها ظاهر میشوند.
Testing
برای Functionهای Algorithmic میتوان Testهای مشخص با Output قابل پیشبینی نوشت. Property-based Testing نیز برای Range وسیع Inputها مفید است.
Benchmarking
Big-O باید با Benchmark واقعی تکمیل شود. Constant Factor، Interpreter Overhead و Cache روی Performance اثر دارند.
Benchmark باید Representative باشد و چند بار تکرار شود.
Profiling
قبل از تغییر Structure یا Algorithm باید Bottleneck واقعی اندازهگیری شود. Optimization بدون Profiling ممکن است روی بخش بیاهمیت وقت بگذارد.
Trade-off سادگی و سرعت
برای Data کوچک، راهحل O(n²) ساده گاهی کاملاً کافی است. Complexity اضافه باید با نیاز واقعی توجیه شود.
Maintainability نیز بخشی از هزینه Algorithm است.
ارتباط با مصاحبه فنی
ساختمان دادهها و الگوریتمها موضوع رایج مصاحبههای فنی هستند، اما هدف نباید فقط حفظ Solution باشد. باید بتوان Complexity و دلیل انتخاب Structure را توضیح داد.
ارتباط با Backend
Cache، Queue، Graph، Search و Indexing در Backend کاربرد مستقیم دارند. فهم ساختمان داده به طراحی Serviceهای مقیاسپذیر کمک میکند.
ارتباط با Data Science
پردازش Dataset بزرگ، Priority Queue، Hashing و Graph Algorithmها در تحلیل داده نیز دیده میشوند.
ارتباط با Machine Learning
بسیاری از Libraryهای ML در سطح داخلی از Matrix، Tree، Heap و Graph استفاده میکنند. فهم آنها کمک میکند Behavior ابزارها بهتر درک شود.
محدودیت نسخه
Syntax یا Libraryهای Python از زمان انتشار کتاب تغییر کردهاند. برخی Exampleها ممکن است نیازمند اصلاح جزئی باشند.
مفاهیم اصلی Data Structure و Algorithm مستقل از Version باقی میمانند.
روش مطالعه پیشنهادی
هر Structure را ابتدا از نظر Concept بفهمید، سپس یک نسخه آموزشی پیاده کنید و در نهایت Built-in استاندارد Python را مقایسه کنید.
برای هر Algorithm Complexity زمان و حافظه را پیش از اجرا حدس بزنید و سپس Benchmark کنید.
این کتاب برای چه کسانی مناسب است؟
- برنامهنویسان Python در سطح مقدماتی تا متوسط.
- دانشجویان علوم کامپیوتر و مهندسی نرمافزار.
- افرادی که برای مصاحبه فنی آماده میشوند.
- توسعهدهندگان Backend و Data.
- کسانی که میخواهند انتخاب Data Structure را آگاهانهتر انجام دهند.
جمعبندی
Python Data Structures and Algorithms اثر Benjamin Baka مجموعهای از مفاهیم بنیادی را به زبان Python به هم متصل میکند: List، Stack، Queue، Linked List، Tree، Heap، Graph، Sorting، Searching و الگوهای طراحی Algorithm.
ارزش اصلی کتاب در تغییر نگاه خواننده از «کدی که کار میکند» به «راهحلی که با داده بزرگ نیز رفتار مناسبی دارد» است. وقتی Complexity، Memory و Pattern دسترسی در تصمیمگیری وارد شوند، انتخاب Structure و Algorithm به بخشی آگاهانه از مهندسی نرمافزار تبدیل میشود.




نقد و بررسیها
هنوز بررسیای ثبت نشده است.