
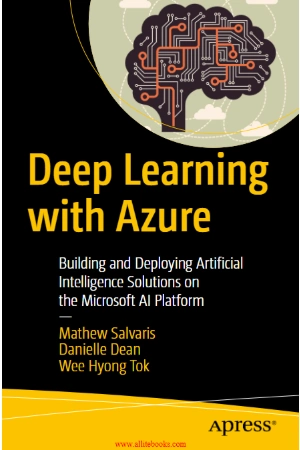

کتاب Deep Learning with Azure (یادگیری عمیق با Azure) نسخه انگلیسی PDF
قیمت اصلی ۸۹.۰۰۰ تومان بود.۴۵.۰۰۰ تومانقیمت فعلی ۴۵.۰۰۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 303 صفحه
- حجم فایل: 7.68 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
خرید و دانلود کتاب Deep Learning with Azure نسخه انگلیسی PDF
کتاب Deep Learning with Azure راهنمایی کاربردی برای آشنایی با توسعه، آموزش و استقرار مدلهای یادگیری عمیق در بستر رایانش ابری Microsoft Azure است. این کتاب به خواننده کمک میکند ارتباط میان شبکههای عصبی، زیرساخت محاسباتی ابری، مدیریت داده و ارائه مدل بهصورت یک سرویس قابل استفاده را درک کند.
اجرای پروژههای یادگیری عمیق معمولاً به داده زیاد، توان پردازشی مناسب و فرایندهای قابل تکرار نیاز دارد. Azure مجموعهای از خدمات ابری برای ذخیرهسازی داده، ساخت محیط محاسباتی، استفاده از پردازندههای گرافیکی، مدیریت آزمایشها و استقرار مدل فراهم میکند. کتاب یادگیری عمیق با Azure این اجزا را در قالب یک مسیر عملی معرفی میکند.
معرفی کتاب Deep Learning with Azure
ساخت یک مدل شبکه عصبی تنها به نوشتن کد آموزش محدود نمیشود. داده باید از منابع مختلف دریافت و آماده شود، محیط اجرای مناسب انتخاب گردد، مدل آموزش ببیند، عملکرد آن ارزیابی شود و در نهایت خروجی به یک برنامه یا کاربر تحویل داده شود.
کتاب Deep Learning with Azure بر این چرخه کامل تمرکز دارد. خواننده با مفاهیم پایه یادگیری عمیق آشنا میشود و سپس میبیند چگونه میتوان منابع ابری Azure را برای اجرای آزمایشها، مدیریت دادهها و انتشار مدل به کار گرفت.
این منبع برای برنامهنویسان پایتون، دانشجویان هوش مصنوعی، متخصصان داده و توسعهدهندگانی مناسب است که میخواهند مدلهای یادگیری عمیق را از محیط شخصی به یک زیرساخت مقیاسپذیر منتقل کنند.
یادگیری عمیق چیست؟
یادگیری عمیق شاخهای از یادگیری ماشین است که از شبکههای عصبی چندلایه برای یادگیری الگوهای پیچیده استفاده میکند. این مدلها میتوانند ویژگیهای مناسب را از دادههایی مانند تصویر، متن، صدا و سری زمانی استخراج کنند.
شبکههای عمیق در مسائلی مانند تشخیص تصویر، تحلیل احساسات، شناسایی گفتار، پیشبینی و پردازش زبان طبیعی کاربرد دارند. آموزش آنها ممکن است به محاسبات سنگین و حافظه زیاد نیاز داشته باشد؛ به همین دلیل استفاده از زیرساخت ابری میتواند مفید باشد.
رایانش ابری امکان میدهد منابع محاسباتی متناسب با نیاز پروژه انتخاب شوند و پس از پایان کار کاهش یابند. این انعطاف برای آزمایش مدلهای مختلف و پردازش مجموعهدادههای بزرگ اهمیت دارد.
Azure چه نقشی در پروژههای یادگیری عمیق دارد؟
Microsoft Azure یک بستر رایانش ابری است که خدمات متنوعی برای محاسبات، ذخیرهسازی، شبکه، داده و هوش مصنوعی ارائه میدهد. در پروژه یادگیری عمیق میتوان از آن برای آمادهسازی محیط آموزش، نگهداری داده، اجرای محاسبات و ارائه مدل استفاده کرد.
یک تیم میتواند محیطهای جداگانه برای توسعه و تولید ایجاد کند، آزمایشها را روی منابع قدرتمندتر اجرا نماید و مدل نهایی را بهصورت یک نقطه دسترسی در اختیار برنامهها قرار دهد.
نام و رابط برخی خدمات Azure در طول زمان تغییر میکند. بنابراین هنگام اجرای مثالهای کتاب بهتر است نسخه ابزارها و مستندات مربوط به محیط مورد استفاده بررسی شود. با این حال، اصول طراحی چرخه یادگیری ماشین همچنان قابل استفاده هستند.
در کتاب Deep Learning with Azure چه میآموزید؟
آمادهسازی حساب و محیط Azure
برای شروع پروژه باید منابع موردنیاز در یک محیط ابری سازماندهی شوند. کتاب به شناخت مفاهیمی مانند اشتراک، گروه منابع، منطقه جغرافیایی و سرویسهای مورد استفاده کمک میکند.
سازماندهی صحیح منابع باعث میشود هزینهها، مجوزها و اجزای پروژه بهتر مدیریت شوند و حذف یا انتقال آنها آسانتر باشد.
ساخت محیط توسعه پایتون
مدلهای یادگیری عمیق معمولاً با پایتون و کتابخانههای تخصصی توسعه داده میشوند. محیط اجرای پروژه باید شامل نسخه مناسب پایتون، وابستگیها و ابزارهای موردنیاز باشد.
استفاده از محیطهای جداگانه و ثبت وابستگیها، اجرای دوباره پروژه را قابل اعتمادتر میکند و از ناسازگاری میان نسخه کتابخانهها جلوگیری مینماید.
انتخاب منبع محاسباتی
نوع ماشین محاسباتی به اندازه داده، معماری مدل و مدت آموزش بستگی دارد. برای آزمایشهای ساده ممکن است پردازنده معمولی کافی باشد، اما شبکههای بزرگ معمولاً از پردازنده گرافیکی بهره میبرند.
کتاب به ایجاد دیدی عملی درباره انتخاب منابع کمک میکند. انتخاب بیش از حد بزرگ هزینه را افزایش میدهد و انتخاب ضعیف نیز زمان آموزش را طولانی میکند.
استفاده از GPU برای آموزش مدل
پردازندههای گرافیکی قادر هستند تعداد زیادی عملیات ماتریسی را بهصورت موازی اجرا کنند. این قابلیت در آموزش شبکههای عصبی عمیق اهمیت زیادی دارد.
خواننده با منطق استفاده از ماشینهای دارای GPU و الزامات نرمافزاری آنها آشنا میشود. هماهنگی میان درایور، کتابخانه محاسباتی و چارچوب یادگیری عمیق برای اجرای صحیح ضروری است.
ذخیرهسازی داده در فضای ابری
دادههای آموزشی ممکن است شامل فایلهای جدولی، تصویر، متن یا خروجی حسگرها باشند. فضای ذخیرهسازی ابری امکان نگهداری و اشتراکگذاری این دادهها میان محیطهای مختلف را فراهم میکند.
دسترسی به داده باید با سطح مجوز مناسب، ساختار پوشه روشن و سیاست نگهداری مشخص انجام شود. امنیت داده و هزینه انتقال نیز باید در طراحی مورد توجه قرار گیرند.
دریافت و آمادهسازی داده
پیش از آموزش مدل، داده باید بررسی، پاکسازی و به قالب مناسب تبدیل شود. مقادیر ناقص، نمونههای تکراری، برچسبهای اشتباه و تفاوت مقیاس میتوانند نتیجه را تحت تأثیر قرار دهند.
کتاب بر ساخت یک فرایند قابل تکرار برای آمادهسازی داده تأکید دارد تا همان تبدیلها در آموزش، ارزیابی و پیشبینی واقعی اجرا شوند.
تقسیم داده به آموزش، اعتبارسنجی و آزمایش
مجموعه آموزش برای تنظیم پارامترهای مدل استفاده میشود. داده اعتبارسنجی به انتخاب معماری و ابرپارامترها کمک میکند و مجموعه آزمایش برای ارزیابی نهایی نگه داشته میشود.
جلوگیری از نشت اطلاعات میان این مجموعهها اهمیت زیادی دارد؛ زیرا نشت داده میتواند نتیجهای ظاهراً عالی اما غیرواقعی ایجاد کند.
ساخت شبکه عصبی
شبکه عصبی از لایههای مختلفی تشکیل میشود که ورودی را به نمایشهای پیچیدهتر تبدیل میکنند. انتخاب تعداد لایهها، اندازه هر لایه و تابع فعالسازی بر توان مدل اثر میگذارد.
کتاب به خواننده کمک میکند اجزای اصلی شبکه، وزنها، بایاسها و نحوه عبور داده از مدل را درک کند.
تابع هزینه و بهینهسازی
تابع هزینه اختلاف میان خروجی مدل و پاسخ واقعی را اندازهگیری میکند. الگوریتم بهینهسازی بر اساس این خطا پارامترهای شبکه را تغییر میدهد.
انتخاب تابع هزینه و نرخ یادگیری مناسب برای رسیدن به آموزش پایدار ضروری است. نرخ نامناسب میتواند باعث کندی یا نوسان در فرایند یادگیری شود.
شبکههای کانولوشنی
شبکههای کانولوشنی برای پردازش تصویر و دادههای دارای ساختار مکانی مناسب هستند. فیلترهای قابل آموزش میتوانند ویژگیهایی مانند لبه، بافت و شکل را شناسایی کنند.
این معماری در طبقهبندی تصویر، تشخیص شیء و تحلیل دادههای بصری کاربرد دارد. زیرساخت ابری اجرای آزمایش با مجموعهدادههای بزرگتر را آسانتر میکند.
شبکههای بازگشتی و دادههای دنبالهای
برای متن، صدا و سری زمانی، ترتیب داده اهمیت دارد. شبکههای بازگشتی و معماریهای مرتبط میتوانند اطلاعات مراحل قبلی را در پردازش مرحله فعلی وارد کنند.
این مدلها در پیشبینی دنباله، تحلیل متن و شناسایی الگوهای زمانی کاربرد دارند و معمولاً به آمادهسازی متفاوتی نسبت به داده تصویری نیازمند هستند.
انتقال یادگیری
در انتقال یادگیری، یک مدل از پیش آموزشدیده بهعنوان نقطه شروع استفاده میشود. این روش میتواند زمان آموزش و مقدار داده موردنیاز را کاهش دهد.
بخشی از لایهها ثابت نگه داشته میشوند و لایههای پایانی برای مسئله جدید تنظیم میگردند. این رویکرد بهویژه در پروژههای تصویری با داده محدود مفید است.
افزایش داده
افزایش داده با ایجاد تغییرات کنترلشده در نمونههای آموزشی، تنوع مجموعه را بیشتر میکند. چرخش، برش یا تغییر اندازه تصویر نمونههایی از این روش هستند.
این کار میتواند بیشبرازش را کاهش دهد، اما تبدیلها باید با ماهیت مسئله سازگار باشند و معنای برچسب را تغییر ندهند.
تنظیم ابرپارامترها
تعداد لایهها، نرخ یادگیری، اندازه دسته و میزان منظمسازی از ابرپارامترهای مهم هستند. انتخاب آنها معمولاً نیاز به اجرای چند آزمایش دارد.
زیرساخت ابری امکان اجرای منظم یا موازی آزمایشها را فراهم میکند. ثبت نتیجه هر اجرا برای مقایسه منصفانه مدلها ضروری است.
ثبت آزمایشها
هر آزمایش باید همراه با نسخه داده، کد، تنظیمات، معیارها و فایل مدل ثبت شود. بدون این اطلاعات بازسازی یک نتیجه موفق دشوار خواهد بود.
کتاب اهمیت مدیریت آزمایش و جداسازی نتیجههای مختلف را نشان میدهد. این کار همکاری تیمی و عیبیابی را نیز آسانتر میکند.
ارزیابی عملکرد مدل
معیار ارزیابی باید متناسب با مسئله انتخاب شود. دقت ساده برای تمام مسائل کافی نیست و ممکن است در دادههای نامتوازن تصویری گمراهکننده ارائه دهد.
برای طبقهبندی میتوان از معیارهایی مانند Precision، Recall و F1 استفاده کرد. در رگرسیون نیز خطای مطلق یا مربعی بر اساس کاربرد انتخاب میشود.
تشخیص بیشبرازش و کمبرازش
بیشبرازش زمانی رخ میدهد که مدل داده آموزشی را خوب یاد میگیرد اما روی داده جدید ضعیف عمل میکند. کمبرازش نیز نشان میدهد مدل حتی الگوهای اصلی داده آموزشی را نیاموخته است.
مقایسه روند خطای آموزش و اعتبارسنجی به تشخیص این وضعیت کمک میکند. افزایش داده، منظمسازی یا تغییر پیچیدگی مدل از راهکارهای متداول هستند.
ذخیره و نسخهبندی مدل
پس از آموزش باید وزنها، ساختار و اطلاعات موردنیاز برای بارگذاری مدل ذخیره شوند. نسخهبندی امکان میدهد مشخص شود هر مدل با کدام داده و تنظیمات ساخته شده است.
در محیط تولید باید امکان بازگشت به نسخه قبلی وجود داشته باشد تا در صورت بروز مشکل، سرویس سریعتر پایدار شود.
استقرار مدل بهصورت سرویس
برای استفاده برنامهها از مدل، معمولاً یک رابط پیشبینی ایجاد میشود. درخواست شامل داده ورودی است و سرویس پس از آمادهسازی، خروجی مدل را بازمیگرداند.
استقرار موفق نیازمند مدیریت وابستگیها، بارگذاری مدل، اعتبارسنجی ورودی، مدیریت خطا و ثبت رویدادها است.
پیشبینی برخط و دستهای
در پیشبینی برخط، پاسخ باید با تأخیر کم ارائه شود. در پردازش دستهای، تعداد زیادی نمونه در یک زمان مشخص پردازش میشوند.
نوع کاربرد تعیین میکند کدام روش مناسبتر است. سامانه پیشنهاد لحظهای و گزارش شبانه نیازهای معماری متفاوتی دارند.
مقیاسپذیری سرویس مدل
با افزایش تعداد درخواستها، سرویس باید منابع بیشتری در اختیار بگیرد یا درخواستها را میان چند نمونه توزیع کند. ظرفیت باید متناسب با الگوی مصرف تنظیم شود.
مقیاسپذیری تنها به توان محاسباتی وابسته نیست؛ زمان آمادهسازی داده، اندازه مدل و ارتباط شبکه نیز بر سرعت پاسخ اثر میگذارند.
پایش مدل در محیط واقعی
عملکرد مدل پس از استقرار ممکن است به دلیل تغییر رفتار کاربران یا توزیع داده کاهش یابد. بنابراین باید کیفیت پیشبینی، زمان پاسخ و نرخ خطا پایش شوند.
تشخیص تغییر داده و مقایسه آن با داده آموزشی به تیم کمک میکند زمان مناسب بازآموزی مدل را تشخیص دهد.
مدیریت هزینههای ابری
ماشینهای دارای GPU و منابع ذخیرهسازی میتوانند هزینه قابل توجهی ایجاد کنند. خاموش کردن منابع بدون استفاده، انتخاب اندازه مناسب و بررسی مصرف از اقدامات مهم مدیریت هزینه هستند.
در پروژه آزمایشی باید مشخص باشد هر اجرا چه ارزش و چه هزینهای دارد. این نگاه مانع ایجاد منابع فراموششده و هزینههای غیرضروری میشود.
امنیت و کنترل دسترسی
داده، مدل و کلیدهای دسترسی باید از کاربران غیرمجاز محافظت شوند. مجوزها بهتر است بر اساس نقش و اصل کمترین دسترسی تعریف گردند.
اطلاعات حساس نباید مستقیماً در کد قرار گیرند. استفاده از راهکارهای مدیریت رازها و ثبت فعالیتها، امنیت محیط را افزایش میدهد.
کاربردهای عملی یادگیری عمیق در Azure
طبقهبندی تصاویر
مدل میتواند تصاویر را در گروههای مشخص قرار دهد. این قابلیت در کنترل کیفیت، تشخیص نوع محصول و سازماندهی محتوای تصویری کاربرد دارد.
تشخیص و تحلیل متن
شبکههای عمیق میتوانند برای طبقهبندی اسناد، تحلیل احساسات، تشخیص موضوع یا استخراج الگو از متن استفاده شوند.
پیشبینی سری زمانی
دادههای فروش، مصرف، تقاضا و عملکرد تجهیزات را میتوان برای پیشبینی آینده تحلیل کرد. اجرای ابری برای پردازش چند منبع داده و آموزش دورهای مناسب است.
تشخیص ناهنجاری
مدل میتواند الگوهای غیرعادی را در تراکنش، رفتار سیستم یا داده حسگر شناسایی کند. این کاربرد در امنیت، نگهداری تجهیزات و کنترل کیفیت ارزشمند است.
پردازش دادههای پزشکی و علمی
یادگیری عمیق در تحلیل تصویر و دادههای پیچیده علمی کاربرد دارد. در چنین پروژههایی، امنیت، حریم خصوصی و کنترل دسترسی اهمیت ویژهای دارند.
سامانههای پیشنهاددهنده
رفتار کاربران و ویژگی محصولات میتوانند برای ساخت پیشنهادهای شخصیسازیشده استفاده شوند. معماری ابری امکان اتصال مدل به سامانههای عملیاتی را فراهم میکند.
مهارتهایی که با مطالعه کتاب تقویت میشوند
طراحی چرخه یادگیری عمیق: شناخت مراحل داده، آموزش، ارزیابی و استقرار.
انتخاب زیرساخت ابری: تشخیص نوع منبع محاسباتی مناسب برای هر پروژه.
کار با داده در فضای ابری: نگهداری، دسترسی و آمادهسازی داده برای آموزش.
ساخت شبکه عصبی: انتخاب لایهها، تابع هزینه و روش بهینهسازی.
مدیریت آزمایشها: ثبت تنظیمات، معیارها و نسخه مدلها.
استفاده از GPU: اجرای آموزش سنگینتر روی منابع محاسباتی مناسب.
استقرار مدل: ارائه پیشبینی بهصورت سرویس برخط یا پردازش دستهای.
پایش و نگهداری: بررسی عملکرد مدل و تشخیص نیاز به بازآموزی.
مدیریت امنیت و هزینه: کنترل دسترسی و استفاده مسئولانه از منابع ابری.
کتاب Deep Learning with Azure برای چه کسانی مناسب است؟
برنامهنویسان پایتون
توسعهدهندگانی که با پایتون آشنا هستند و میخواهند پروژههای شبکه عصبی را روی زیرساخت ابری اجرا کنند، از این کتاب بهره خواهند برد.
دانشجویان هوش مصنوعی و علم داده
دانشجویان میتوانند ارتباط میان الگوریتمهای یادگیری عمیق و الزامات عملی اجرای آنها را بهتر درک کنند.
مهندسان یادگیری ماشین
افرادی که قصد دارند مدل را از محیط آزمایش به سرویس قابل استفاده منتقل کنند، با مفاهیم استقرار، نسخهبندی و پایش آشنا میشوند.
متخصصان رایانش ابری
کارشناسان Azure میتوانند شناخت خود از زیرساخت ابری را با مفاهیم داده و یادگیری عمیق ترکیب کنند.
توسعهدهندگان نرمافزار
توسعهدهندگانی که میخواهند قابلیت تشخیص، پیشبینی یا تحلیل هوشمند را به برنامههای خود اضافه کنند، از شناخت چرخه ارائه مدل سود میبرند.
مدیران و معماران فنی
افرادی که مسئول انتخاب معماری و برآورد منابع هستند میتوانند با اجزای اصلی پروژه و عوامل مؤثر بر هزینه، امنیت و مقیاس آشنا شوند.
پیشنیازهای مطالعه کتاب
آشنایی با زبان پایتون، مفاهیم پایه یادگیری ماشین و اصول شبکههای عصبی برای دنبال کردن بهتر مطالب مفید است.
شناخت مقدماتی جبر خطی، احتمال و گرادیان به درک فرایند آموزش کمک میکند. تجربه اولیه کار با خط فرمان و محیطهای ابری نیز میتواند اجرای تمرینها را آسانتر سازد.
برای استفاده عملی از خدمات Azure لازم است ساختار حساب، مجوزها و هزینه منابع با دقت مدیریت شود.
نکته مهم درباره نسخه خدمات Azure
خدمات ابری، نام محصولات و رابطهای برنامهنویسی در طول زمان تغییر میکنند. ممکن است تصویرها، منوها یا دستورهای نسخه کتاب با محیط فعلی Azure یکسان نباشند.
هنگام اجرای مثالها بهتر است مفهوم هر مرحله شناسایی و سپس معادل آن در نسخه فعلی خدمات بررسی شود. اصولی مانند آمادهسازی داده، انتخاب محاسبات، ثبت آزمایش، استقرار و پایش همچنان معتبر باقی میمانند.
همچنین کتابخانههای یادگیری عمیق ممکن است در نسخههای جدید تغییر کرده باشند؛ بنابراین ثبت نسخه وابستگیها و مراجعه به مستندات فنی اهمیت دارد.
چرا مطالعه Deep Learning with Azure مفید است؟
بسیاری از آموزشهای یادگیری عمیق پس از رسیدن به یک مدل در محیط محلی پایان مییابند، در حالی که پروژه واقعی به زیرساخت، امنیت، استقرار و نگهداری نیاز دارد.
این کتاب به خواننده کمک میکند مدل را بهعنوان بخشی از یک سیستم بزرگتر ببیند و برای انتقال آن از مرحله آزمایش به مرحله استفاده عملی آماده شود.
ترکیب دانش شبکههای عصبی با رایانش ابری میتواند فرصتهای بیشتری برای ساخت سامانههای مقیاسپذیر در حوزه تصویر، متن، پیشبینی و تحلیل داده ایجاد کند.
نسخه انگلیسی کتاب Deep Learning with Azure با فرمت PDF
محصول حاضر شامل نسخه انگلیسی کتاب Deep Learning with Azure با فرمت PDF است. فایل PDF را میتوان روی رایانه، لپتاپ، تبلت و تلفن همراه مطالعه کرد.
مطالعه نسخه انگلیسی به خواننده کمک میکند اصطلاحات تخصصی یادگیری عمیق، رایانش ابری، استقرار مدل و خدمات Azure را به زبان اصلی بشناسد و برای مطالعه مستندات فنی آمادهتر شود.
جمعبندی معرفی کتاب Deep Learning with Azure
کتاب Deep Learning with Azure نسخه انگلیسی PDF منبعی کاربردی برای شناخت چرخه ساخت مدلهای یادگیری عمیق در بستر Microsoft Azure است. این کتاب موضوعاتی مانند آمادهسازی داده، انتخاب منابع محاسباتی، استفاده از GPU، آموزش شبکه عصبی، ثبت آزمایشها، ارزیابی، استقرار و پایش مدل را در یک مسیر منظم بررسی میکند.
اگر با پایتون و مبانی یادگیری عمیق آشنا هستید و میخواهید پروژههای خود را روی زیرساخت ابری اجرا یا به یک سرویس قابل استفاده تبدیل کنید، این کتاب میتواند راهنمای مناسبی برای توسعه مهارتهای فنی شما باشد.





نقد و بررسیها
هنوز بررسیای ثبت نشده است.