
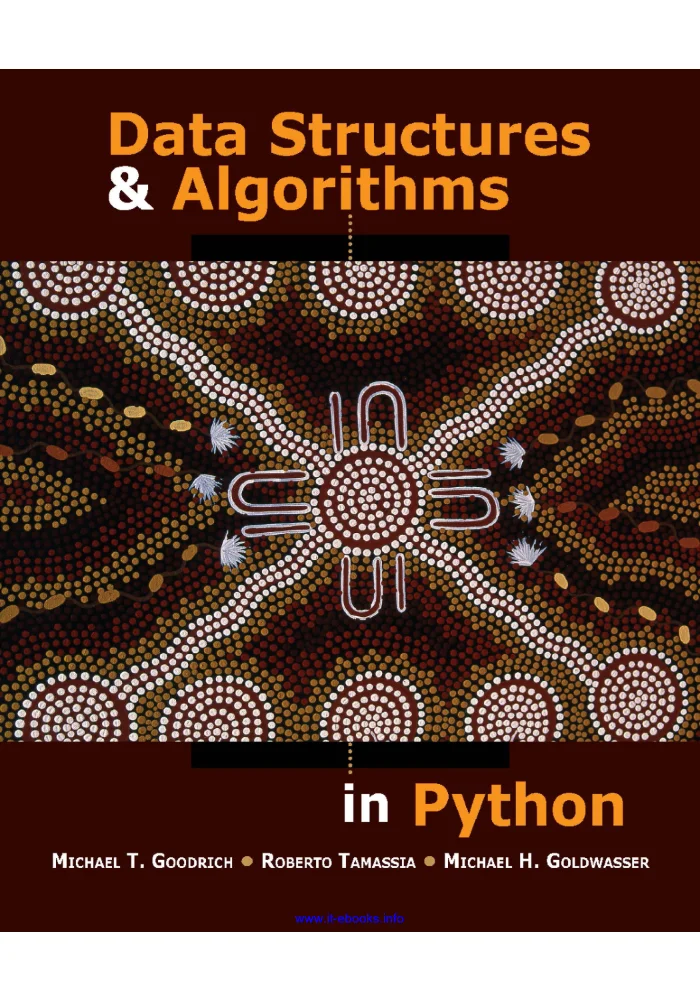


کتاب ساختار داده و الگوریتم در پایتون اثر مایکل گودریچ و روبرتو تاماسیا نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 770 صفحه
- حجم فایل: 6.6 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب Data Structures and Algorithms in Python اثر Michael Goodrich و Roberto Tamassia
Data Structures and Algorithms in Python اثری آموزشی درباره طراحی ساختمان داده، تحلیل الگوریتم و پیادهسازی آنها با Python است. فایل این محصول به زبان انگلیسی و 770 صفحه ثبت شده و در متادیتای محصول نام Michael Goodrich و Roberto Tamassia درج شده است. این کتاب برای خوانندهای مناسب است که میخواهد از سطح استفاده روزمره از List و Dictionary عبور کند و بفهمد ساختارهای داده چگونه طراحی میشوند، چه هزینه زمانی و حافظهای دارند و چگونه انتخاب یک ساختار مناسب میتواند عملکرد برنامه را تغییر دهد.
موضوع ساختمان داده فقط حفظ کردن نام چند Structure نیست. مسئله اصلی این است که برای هر نوع عملیات، مانند Search، Insert، Delete، Traversal یا Priority Access، ساختاری انتخاب شود که هزینه مناسبی داشته باشد. کتاب با ترکیب تحلیل ریاضی و مثالهای Python کمک میکند این تصمیمها بر اساس Complexity و ویژگی مسئله انجام شوند.
تحلیل الگوریتم
یکی از پایههای کتاب تحلیل رشد زمان اجرا و مصرف حافظه است. Big-O برای توصیف رفتار Algorithm هنگام افزایش اندازه Input استفاده میشود.
O(1)، O(log n)، O(n)، O(n log n) و O(n²) از Complexityهای رایج هستند. هدف Big-O محاسبه دقیق میلیثانیه نیست، بلکه مقایسه Scalability الگوریتمهاست.
Asymptotic Analysis
در تحلیل Asymptotic، Constantها و جزئیات کوچک کنار گذاشته میشوند تا نرخ رشد اصلی دیده شود. برای Dataset کوچک ممکن است دو Algorithm تفاوت کمی داشته باشند، اما در مقیاس بزرگ Complexity تعیینکننده میشود.
Python و مدل شیءگرا
برای پیادهسازی ساختمان داده، درک Class، Object، Inheritance و Encapsulation مهم است. Python امکان میدهد Abstract Data Typeها با Interface روشن طراحی شوند.
بهتر است Consumer یک Data Structure به جزئیات داخلی Implementation وابسته نباشد.
Abstract Data Types
ADT رفتار مورد انتظار را تعریف میکند، نه روش پیادهسازی را. برای مثال Stack مشخص میکند عملیات Push و Pop چگونه رفتار کنند، اما میتوان آن را با Array یا Linked Structure ساخت.
Array
Array دسترسی Index-based سریع ارائه میدهد. در Dynamic Array، Capacity میتواند هنگام پر شدن افزایش یابد.
Append معمولاً Amortized O(1) است، اما Insert در ابتدای Array نیازمند جابهجایی عناصر و معمولاً O(n) است.
Dynamic Array
Dynamic Array ظرفیت بیشتری از تعداد عناصر واقعی نگه میدارد. هنگام پر شدن، Array بزرگتر ساخته و عناصر Copy میشوند.
اگرچه Resize منفرد پرهزینه است، تحلیل Amortized نشان میدهد هزینه متوسط Append همچنان مناسب باقی میماند.
Linked List
Linked List از Nodeهایی تشکیل میشود که به Node بعدی یا قبلی Reference دارند. Insert و Delete در Position شناختهشده میتواند بسیار ارزان باشد.
در مقابل، دسترسی Random به عنصر شماره i مانند Array مستقیم نیست و نیاز به Traversal دارد.
Singly Linked List
در Singly Linked List هر Node فقط Reference به Node بعدی دارد. این ساختار ساده و کمهزینه است، اما حرکت مستقیم به عقب امکانپذیر نیست.
Doubly Linked List
در Doubly Linked List هر Node به قبلی و بعدی متصل است. Delete و Traversal دوطرفه سادهتر میشود، اما Memory بیشتری مصرف میشود.
Stack
Stack از سیاست LIFO استفاده میکند؛ آخرین عنصر واردشده اولین عنصر خارجشده است. Function Call Stack، Undo و Parsing از کاربردهای رایج هستند.
Push، Pop و Top معمولاً باید عملیات سریع باشند.
Queue
Queue از سیاست FIFO استفاده میکند؛ اولین عنصر واردشده اولین عنصر خارجشده است. صف درخواستها، Task Scheduling و Breadth-First Search از کاربردهای آن هستند.
Deque
Deque اجازه Insert و Delete از هر دو سر را میدهد. این ساختار میتواند در Sliding Window و برخی Algorithmهای Queue/Stack کاربرد داشته باشد.
Recursion
Recursion مسئله را به نسخه کوچکتر خودش تبدیل میکند. Base Case برای توقف ضروری است.
درک Call Stack و هزینه حافظه Recursion برای طراحی Algorithm مهم است.
Divide and Conquer
در Divide and Conquer مسئله به زیرمسئلههای کوچک تقسیم میشود، هر بخش حل و نتایج ترکیب میشوند. Merge Sort نمونه کلاسیک این الگو است.
Tree
Tree ساختاری سلسلهمراتبی از Nodeهاست. Root، Parent، Child، Sibling، Depth و Height از مفاهیم پایه هستند.
File System، DOM و Expression Tree نمونههایی از ساختار درختیاند.
Binary Tree
در Binary Tree هر Node حداکثر دو Child دارد. این محدودیت پایه بسیاری از Algorithmها و Search Treeهاست.
Tree Traversal
Preorder، Inorder و Postorder روشهای مهم پیمایش Tree هستند. انتخاب Traversal به هدف مسئله بستگی دارد.
Breadth-First Traversal نیز Tree را Level-by-Level بررسی میکند.
Binary Search Tree
BST ترتیب Keyها را طوری حفظ میکند که Search، Insert و Delete در حالت متوازن معمولاً O(log n) باشند.
اگر Tree بسیار نامتوازن شود، عملکرد میتواند به O(n) سقوط کند.
Balanced Search Trees
ساختارهای Balanced تلاش میکنند Height را کنترل کنند تا عملیات Search قابل پیشبینی باقی بماند.
مفهوم Balance نشان میدهد Structure داخلی چگونه روی Complexity اثر میگذارد.
Priority Queue
Priority Queue عنصر را بر اساس Priority خارج میکند، نه صرفاً ترتیب ورود. Scheduler و الگوریتمهای Graph از کاربردهای مهم هستند.
Heap
Binary Heap یکی از پیادهسازیهای رایج Priority Queue است. Minimum یا Maximum در Root قرار دارد و Insert و Remove معمولاً O(log n) هستند.
Heap را میتوان به شکل فشرده داخل Array ذخیره کرد.
Heap Sort
Heap میتواند برای Sorting نیز استفاده شود. Heap Sort زمان O(n log n) دارد و به Structure Priority Queue تکیه میکند.
Map
Map مجموعه Key-Value است. عملیات اصلی شامل Get، Set و Delete بر اساس Key هستند.
Python Dictionary نمونهای از Map است، اما فهم Implementation کمک میکند محدودیتها و هزینهها بهتر درک شوند.
Hash Table
Hash Table با Hash Function جای مناسب Key را تعیین میکند. در شرایط مناسب Lookup، Insert و Delete متوسط نزدیک به O(1) هستند.
Hash Function
Hash Function باید Key را به Index مناسب تبدیل کند و Distribution نسبتاً یکنواخت ایجاد کند. Collision اجتنابناپذیر است و باید مدیریت شود.
Collision Resolution
Separate Chaining و Open Addressing از روشهای رایج مدیریت Collision هستند. Load Factor روی Performance Hash Table اثر دارد.
Set
Set مجموعهای بدون Duplicate است و Membership Test سریع ارائه میدهد. Union، Intersection و Difference از عملیات مهم آن هستند.
Sorting
مرتبسازی یکی از موضوعات اصلی Algorithm Design است. Selection Sort، Insertion Sort، Merge Sort و Quick Sort رفتارهای متفاوتی دارند.
انتخاب Algorithm به اندازه داده، Memory، Stability و Distribution بستگی دارد.
Insertion Sort
Insertion Sort برای Dataset کوچک یا تقریباً مرتب میتواند ساده و مؤثر باشد، اما Worst-case آن O(n²) است.
Merge Sort
Merge Sort با Divide and Conquer کار میکند و زمان O(n log n) دارد. نیاز به Memory اضافی یکی از Trade-offهای آن است.
Quick Sort
Quick Sort با Pivot داده را Partition میکند. Average Performance آن O(n log n) است، اما انتخاب Pivot نامناسب میتواند Worst-case O(n²) ایجاد کند.
Selection
مسئله Selection مانند پیدا کردن kامین عنصر کوچکتر الزاماً نیازمند Sort کامل نیست. Algorithm مناسب میتواند هزینه کمتری داشته باشد.
Search
Linear Search برای داده نامرتب ساده است و O(n) زمان دارد. Binary Search روی داده مرتب O(log n) است.
شرطهای مسئله تعیین میکنند کدام روش قابل استفاده است.
Graph
Graph از Vertex و Edge تشکیل میشود و برای مدلسازی Network، Route، Dependency و Relation استفاده میشود.
Graph میتواند Directed، Undirected، Weighted یا Unweighted باشد.
Graph Representation
Adjacency List برای Graph Sparse معمولاً حافظه مناسبتری دارد. Adjacency Matrix برای بعضی عملیات و Graph Dense سادهتر است.
Breadth-First Search
BFS با Queue Graph را Level-by-Level پیمایش میکند. برای Shortest Path در Graph بدون Weight مناسب است.
Depth-First Search
DFS با Stack یا Recursion مسیر را تا عمق دنبال میکند. Cycle Detection، Connectivity و Topological Structure از کاربردهای آن هستند.
Shortest Paths
در Graph Weighted، الگوریتمهایی مانند Dijkstra برای Weight غیرمنفی استفاده میشوند. انتخاب Algorithm به ویژگی Edgeها بستگی دارد.
Minimum Spanning Tree
MST مجموعه Edgeهایی است که همه Vertexها را با کمترین وزن کل متصل میکند. طراحی Network یکی از کاربردهای آن است.
Topological Ordering
در Directed Acyclic Graph میتوان Vertexها را طوری مرتب کرد که هر Dependency پیش از وابسته آن قرار گیرد. Build System و Course Prerequisite نمونههای کاربردیاند.
Text Processing
String نیز یک Structure داده است و Algorithmهای Pattern Matching برای Search متن اهمیت دارند.
روش ساده Character-by-Character همیشه برای Text بزرگ بهترین گزینه نیست.
Memory Efficiency
Complexity فقط زمان نیست. Data Structure میتواند Memory Overhead زیادی ایجاد کند.
در Python هر Object Metadata و Reference دارد و این موضوع در میلیونها عنصر اهمیت پیدا میکند.
Amortized Analysis
برخی عملیات گاهی بسیار پرهزینهاند اما به ندرت رخ میدهند. Amortized Analysis هزینه متوسط یک Sequence از عملیات را بررسی میکند.
Dynamic Array نمونه مهم این مفهوم است.
Space-Time Trade-off
گاهی با مصرف Memory بیشتر میتوان سرعت را افزایش داد؛ Cache و Hash Table نمونهاند. در شرایط Memory محدود ممکن است Trade-off معکوس لازم باشد.
Algorithm Correctness
Algorithm خوب فقط سریع نیست، باید برای همه Inputهای معتبر Correct باشد. Loop Invariant و Reasoning ساختاری به اثبات Correctness کمک میکنند.
Edge Cases
Empty Structure، یک عنصر، Duplicate Key و Boundary Index از Edge Caseهای مهم هستند. Test باید این حالتها را پوشش دهد.
Testing Data Structures
برای هر ADT باید Contract عملیات تست شود. مثلاً Push و Pop روی Stack باید ترتیب LIFO را حفظ کنند.
Exception Handling
عملیات نامعتبر مانند Pop از Stack خالی باید رفتار مشخص داشته باشد. Exception مناسب API را قابل پیشبینیتر میکند.
Iterator
Iterator اجازه میدهد Structure بدون آشکار کردن Representation داخلی پیمایش شود. این الگو در Python نقش مهمی دارد.
Generator
Generator برای Traversal Lazy مفید است و لازم نیست همه Resultها همزمان در Memory باشند.
Design Patterns
ساختمان دادهها با مفاهیمی مانند Adapter، Iterator و Composite ارتباط دارند. شناخت Pattern کمک میکند Implementation تمیزتر و Reusableتر شود.
انتخاب ساختمان داده
هیچ Structureای برای همه مسائل بهترین نیست. اگر Lookup زیاد است Hash Map مناسب است؛ اگر Priority مهم است Heap و اگر ترتیب سلسلهمراتبی مهم است Tree گزینه طبیعیتری است.
باید Operations پرتکرار قبل از انتخاب Structure مشخص شوند.
Performance در Python
پیادهسازی آموزشی Structure از صفر برای فهم Algorithm مفید است، اما در Production معمولاً Built-inها و Libraryهای استاندارد بهینهترند.
هدف کتاب فهم منطق پشت ابزارهاست، نه جایگزین کردن بیدلیل Implementationهای استاندارد.
پیچیدگی API و Implementation
Interface ساده میتواند Implementation پیچیدهای داشته باشد. Encapsulation اجازه میدهد بدون تغییر Consumer، Implementation بهبود پیدا کند.
کاربرد در مصاحبه فنی
موضوعات Array، Linked List، Stack، Queue، Tree، Hash Table، Heap و Graph بخش مهمی از مصاحبههای برنامهنویسی هستند.
اما حفظ Solution کافی نیست؛ باید Complexity و دلیل انتخاب روش توضیح داده شود.
روش پیشنهادی مطالعه
بهتر است هر Structure ابتدا با دست رسم شود، سپس Operations آن تحلیل و در نهایت با Python پیادهسازی شود.
پس از آن، Test و Benchmark ساده بنویسید و رفتار Structure را روی Inputهای مختلف بررسی کنید.
این کتاب برای چه کسانی مناسب است؟
- دانشجویان علوم کامپیوتر و مهندسی نرمافزار.
- برنامهنویسان Python که مبانی Algorithm را میخواهند.
- افرادی که برای مصاحبه فنی آماده میشوند.
- توسعهدهندگانی که میخواهند Complexity را در تصمیمهای روزمره به کار ببرند.
- کسانی که به طراحی Data Structure از پایه علاقه دارند.
جمعبندی
Data Structures and Algorithms in Python اثر Michael Goodrich و Roberto Tamassia منبعی گسترده برای یادگیری ساختمان داده و الگوریتم در Python است. تحلیل Complexity، Array، Linked List، Stack، Queue، Tree، Heap، Hash Table، Sorting و Graph از محورهای اصلی آن هستند.
مهمترین ارزش کتاب ایجاد توانایی انتخاب است: برنامهنویس باید بداند هر Structure چه مزیت و هزینهای دارد و Algorithm چگونه با افزایش داده رفتار میکند. برای ساخت پایهای جدی در علوم کامپیوتر و برنامهنویسی Python، این اثر منبع مفصل و کاربردی محسوب میشود.




نقد و بررسیها
هنوز بررسیای ثبت نشده است.