
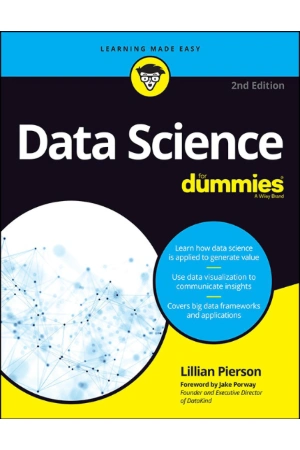


کتاب Data Science For Dummies (علم داده برای مبتدیان) نسخه انگلیسی PDF
قیمت اصلی ۸۹.۰۰۰ تومان بود.۴۵.۰۰۰ تومانقیمت فعلی ۴۵.۰۰۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 329 صفحه
- حجم فایل: 8.92 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
خرید و دانلود کتاب Data Science For Dummies نسخه انگلیسی PDF
کتاب Data Science For Dummies یک راهنمای مقدماتی و قابل فهم برای ورود به دنیای علم داده است. این کتاب به خواننده کمک میکند مفاهیم اصلی جمعآوری، پاکسازی، تحلیل، مدلسازی و تفسیر داده را بدون نیاز به پیشزمینه تخصصی عمیق بشناسد و تصویری منظم از فرایندهای رایج یک پروژه دادهمحور به دست آورد.
علم داده ترکیبی از آمار، برنامهنویسی، شناخت کسبوکار و توانایی حل مسئله است. هدف آن تنها تولید نمودار یا اجرای الگوریتم نیست؛ بلکه تبدیل داده خام به اطلاعات قابل اعتماد و تصمیمهای قابل اجرا است. کتاب علم داده برای مبتدیان این حوزه گسترده را به بخشهای سادهتر تقسیم میکند تا شروع یادگیری برای مخاطب آسانتر شود.
معرفی کتاب Data Science For Dummies
سازمانها، فروشگاهها، بانکها، شبکههای اجتماعی، سامانههای پزشکی و تجهیزات هوشمند هر روز حجم زیادی داده تولید میکنند. این اطلاعات زمانی ارزشمند میشوند که بتوان آنها را بهدرستی سازماندهی، تحلیل و تفسیر کرد.
کتاب Data Science For Dummies توضیح میدهد دانشمند داده چگونه از یک پرسش واقعی آغاز میکند، منابع اطلاعات را شناسایی مینماید، کیفیت داده را بررسی میکند و در نهایت نتیجه را به شکلی روشن در اختیار تصمیمگیرندگان قرار میدهد.
این کتاب برای دانشجویان، مدیران، برنامهنویسان تازهکار، تحلیلگران کسبوکار و افرادی مناسب است که درباره علم داده شنیدهاند اما هنوز مسیر ورود به آن را نمیشناسند.
علم داده چیست؟
علم داده مجموعهای از روشها برای استخراج دانش و الگو از دادههای ساختاریافته و بدون ساختار است. داده ساختاریافته معمولاً در قالب جدول و ستون نگهداری میشود، در حالی که متن، تصویر، صدا، ویدئو و گزارشهای سیستمی نمونههایی از داده بدون ساختار هستند.
یک پروژه علم داده ممکن است با پرسشی مانند پیشبینی فروش، شناسایی مشتریان در معرض ریزش، تشخیص تراکنش مشکوک یا تحلیل نظر کاربران آغاز شود. سپس داده مناسب جمعآوری و برای پاسخ به این پرسش آماده میشود.
علم داده به جای تمرکز صرف بر ابزار، بر ترکیب درست مسئله، داده، روش تحلیلی و تفسیر نتیجه تأکید دارد.
در کتاب Data Science For Dummies چه میآموزید؟
شناخت چرخه کامل پروژه علم داده
پروژه دادهمحور معمولاً شامل تعریف مسئله، جمعآوری داده، پاکسازی، تحلیل اکتشافی، ساخت ویژگی، مدلسازی، ارزیابی و ارائه نتیجه است. کتاب کمک میکند این مراحل را بهصورت یک جریان پیوسته درک کنید.
شناخت چرخه کامل مانع از آن میشود که تحلیلگر مستقیماً سراغ الگوریتم برود و کیفیت داده یا هدف واقعی پروژه را نادیده بگیرد.
تعریف مسئله و هدف تحلیل
یک پروژه موفق با پرسش روشن آغاز میشود. هدف باید مشخص، قابل اندازهگیری و مرتبط با یک تصمیم واقعی باشد.
برای مثال، بهجای هدف مبهم افزایش فروش، میتوان مسئله را به شناسایی مشتریانی تبدیل کرد که احتمال خرید محصول مشخصی در ماه آینده دارند. این تعریف روشن بر انتخاب داده، مدل و معیار ارزیابی اثر میگذارد.
شناخت انواع داده
داده میتواند عددی، دستهای، متنی، زمانی، مکانی یا چندرسانهای باشد. هر نوع داده به روش آمادهسازی و تحلیل متفاوتی نیاز دارد.
کتاب به خواننده کمک میکند تفاوت متغیرهای پیوسته و گسسته، دادههای اسمی و ترتیبی و ساختارهای زمانی را بهتر درک کند.
جمعآوری داده
داده ممکن است از فایل، پایگاه داده، فرم، حسگر، API یا رفتار کاربران به دست آید. پیش از استفاده باید مشخص شود منبع داده معتبر است و اطلاعات با چه هدفی جمعآوری شدهاند.
ثبت زمان، واحد اندازهگیری و شرایط تولید داده برای تفسیر صحیح نتیجه اهمیت دارد.
پاکسازی داده
داده خام معمولاً شامل مقادیر گمشده، رکوردهای تکراری، قالبهای ناسازگار و خطاهای ورود اطلاعات است. پاکسازی این مشکلات بخش مهمی از کار علم داده محسوب میشود.
کتاب نشان میدهد چرا حذف خودکار تمام دادههای ناقص همیشه مناسب نیست و تصمیم پاکسازی باید بر اساس معنی متغیر و هدف تحلیل انجام شود.
مدیریت مقادیر گمشده
مقادیر گمشده ممکن است به دلیل خطای ثبت، عدم پاسخ کاربر یا نبود واقعی اطلاعات ایجاد شوند. نحوه برخورد با آنها میتواند بر نتیجه تحلیل اثر زیادی داشته باشد.
روشهایی مانند حذف محدود، جایگزینی با مقدار مناسب یا ایجاد شاخص گمشده بودن، بسته به نوع مسئله قابل استفاده هستند.
شناسایی دادههای پرت
داده پرت مقداری است که فاصله زیادی با الگوی عمومی دارد. چنین مقداری ممکن است خطا باشد یا یک رویداد واقعی و مهم را نشان دهد.
تحلیلگر باید پیش از حذف مقدار پرت، علت آن را بررسی کند. در برخی پروژهها مانند تشخیص تقلب، همین نمونههای غیرعادی هدف اصلی تحلیل هستند.
تحلیل اکتشافی داده
تحلیل اکتشافی برای شناخت توزیع، روابط و کیفیت داده استفاده میشود. محاسبه آمار توصیفی، بررسی فراوانی و رسم نمودارها میتواند الگوهای اولیه را آشکار کند.
این مرحله به شکلگیری فرضیهها و انتخاب روش مناسب برای مدلسازی کمک میکند.
آمار توصیفی
میانگین، میانه، نما، واریانس و انحراف معیار از شاخصهای مهم توصیف داده هستند. هر شاخص جنبه متفاوتی از مرکز یا پراکندگی را نشان میدهد.
استفاده از تنها یک عدد خلاصه ممکن است ساختار واقعی داده را پنهان کند؛ بنابراین بهتر است چند شاخص و نمودار در کنار یکدیگر بررسی شوند.
احتمال و عدم قطعیت
احتمال ابزاری برای بیان عدم قطعیت است. در علم داده، پیشبینیها معمولاً قطعی نیستند و باید همراه با سطح اطمینان یا احتمال تفسیر شوند.
شناخت مفاهیم پایه احتمال به درک مدلهای آماری، آزمون فرض و ارزیابی ریسک کمک میکند.
همبستگی و رابطه میان متغیرها
همبستگی نشان میدهد دو متغیر تا چه اندازه با یکدیگر تغییر میکنند، اما بهتنهایی رابطه علت و معلولی را ثابت نمیکند.
کتاب بر تفسیر محتاطانه روابط داده و توجه به عوامل پنهان تأکید دارد.
نمونهگیری
در بسیاری از پروژهها بررسی تمام جامعه امکانپذیر نیست و از نمونه استفاده میشود. نمونه باید تا حد ممکن نماینده جامعه هدف باشد.
نمونهگیری نامناسب میتواند سوگیری ایجاد کند و نتیجهای تولید نماید که برای کاربران واقعی قابل تعمیم نیست.
آزمون فرض
آزمون فرض برای بررسی شواهد آماری درباره یک ادعا استفاده میشود. تحلیلگر باید فرض صفر، معیار تصمیم و سطح خطا را بهدرستی تعریف کند.
تفسیر نتیجه آماری باید در کنار اهمیت عملی اثر انجام شود؛ زیرا معناداری آماری همیشه به معنی ارزش تجاری یا علمی بالا نیست.
مهندسی ویژگی
ویژگیها نمایشهایی از داده هستند که مدل برای یادگیری استفاده میکند. تبدیل تاریخ به روز هفته، محاسبه نسبتها یا دستهبندی مقادیر نمونههایی از مهندسی ویژگی هستند.
ویژگی مناسب میتواند کیفیت مدل را بهبود دهد، اما باید تنها از اطلاعاتی استفاده شود که در زمان پیشبینی واقعاً در دسترس هستند.
یادگیری ماشین نظارتشده
در یادگیری نظارتشده، مدل از نمونههایی دارای پاسخ صحیح یاد میگیرد. طبقهبندی و رگرسیون دو گروه اصلی این روش هستند.
طبقهبندی برای پیشبینی یک گروه و رگرسیون برای پیشبینی مقدار عددی استفاده میشود.
یادگیری ماشین بدون نظارت
در یادگیری بدون نظارت، داده برچسب مشخصی ندارد و هدف کشف ساختار پنهان است. خوشهبندی و کاهش ابعاد از روشهای رایج این حوزه هستند.
این روشها برای بخشبندی مشتریان، کشف الگو و سادهسازی دادههای پیچیده کاربرد دارند.
رگرسیون
رگرسیون برای پیشبینی متغیرهای عددی مانند قیمت، فروش یا مصرف انرژی استفاده میشود. مدل تلاش میکند رابطه میان ویژگیها و خروجی را یاد بگیرد.
ارزیابی رگرسیون باید با معیارهایی انجام شود که اندازه و ماهیت خطا را بهدرستی نشان دهند.
طبقهبندی
طبقهبندی برای پیشبینی دسته نمونهها کاربرد دارد؛ مانند تشخیص پیام ناخواسته، احتمال ریزش مشتری یا نوع یک تصویر.
در مسائل نامتوازن، دقت کلی ممکن است گمراهکننده باشد و باید معیارهای دقیقتری نیز بررسی شوند.
خوشهبندی
خوشهبندی نمونههای مشابه را در گروههای جدا قرار میدهد. این روش میتواند بدون داشتن برچسب، ساختار اولیه داده را نشان دهد.
تعداد گروهها و معیار شباهت باید با توجه به مسئله و قابلیت تفسیر نتیجه انتخاب شوند.
درخت تصمیم
درخت تصمیم با مجموعهای از پرسشها داده را به شاخههای مختلف تقسیم میکند. ساختار آن برای بسیاری از کاربران قابل فهم است و امکان توضیح مسیر تصمیم را فراهم میسازد.
درختهای بسیار عمیق ممکن است داده آموزشی را بیش از حد یاد بگیرند؛ بنابراین کنترل پیچیدگی اهمیت دارد.
مدلهای گروهی
مدلهای گروهی چند مدل را با یکدیگر ترکیب میکنند تا پیشبینی پایدارتر و دقیقتری ایجاد شود. جنگل تصادفی و روشهای تقویتی نمونههایی از این رویکرد هستند.
افزایش دقت ممکن است با کاهش سادگی تفسیر همراه باشد و این مبادله باید بر اساس نیاز پروژه سنجیده شود.
تقسیم داده آموزشی و آزمایشی
مدل باید روی دادهای ارزیابی شود که در فرایند آموزش ندیده است. تقسیم داده به آموزش و آزمایش یک روش پایه برای سنجش توان تعمیم است.
در دادههای زمانی، ترتیب مشاهدات باید حفظ شود و تقسیم تصادفی همیشه مناسب نیست.
اعتبارسنجی مدل
اعتبارسنجی متقاطع امکان میدهد مدل روی چند تقسیم متفاوت داده بررسی شود. این روش برآورد پایدارتری از عملکرد فراهم میکند.
تمام مراحل آمادهسازی باید در هر تقسیم فقط با داده آموزشی تنظیم شوند تا نشت اطلاعات رخ ندهد.
بیشبرازش و کمبرازش
بیشبرازش زمانی رخ میدهد که مدل جزئیات و نویز داده آموزشی را یاد بگیرد و روی داده جدید ضعیف عمل کند. کمبرازش نیز به ناتوانی مدل در یادگیری الگوی اصلی اشاره دارد.
کنترل پیچیدگی، افزایش داده و ارزیابی صحیح میتوانند به ایجاد تعادل مناسب کمک کنند.
معیارهای ارزیابی
معیار مناسب باید با هدف پروژه هماهنگ باشد. دقت، بازخوانی، صحت پیشبینی مثبت و امتیاز ترکیبی هرکدام جنبه متفاوتی از عملکرد طبقهبندی را نشان میدهند.
در مسائل مالی، پزشکی یا امنیتی، هزینه انواع مختلف خطا برابر نیست و انتخاب معیار باید این تفاوت را منعکس کند.
مصورسازی داده
نمودارها برای شناخت داده و انتقال نتیجه استفاده میشوند. نمودار میلهای، خطی، پراکندگی، هیستوگرام و جعبهای هرکدام برای نوع مشخصی از پرسش مناسب هستند.
یک نمودار خوب باید عنوان روشن، مقیاس درست و توضیح کافی داشته باشد و از ایجاد برداشت گمراهکننده جلوگیری کند.
داستانگویی با داده
نتیجه تحلیل باید به زبان مخاطب ارائه شود. مدیر، پژوهشگر و برنامهنویس ممکن است به سطح متفاوتی از جزئیات نیاز داشته باشند.
داستانگویی دادهمحور شامل بیان مسئله، شواهد، نتیجه و اقدام پیشنهادی است و به تصمیمگیری کمک میکند.
دادههای بزرگ
وقتی حجم، سرعت یا تنوع داده افزایش مییابد، روشهای معمول ممکن است کافی نباشند. پردازش توزیعشده و ذخیرهسازی مقیاسپذیر برای چنین شرایطی کاربرد دارند.
با این حال، استفاده از فناوری پیچیده باید بر اساس نیاز واقعی انجام شود و هر پروژهای به زیرساخت کلانداده نیاز ندارد.
رایانش ابری
سرویسهای ابری دسترسی به فضای ذخیرهسازی و توان محاسباتی انعطافپذیر را فراهم میکنند. تیمها میتوانند منابع را متناسب با حجم کار افزایش یا کاهش دهند.
هزینه، امنیت، محل نگهداری داده و وابستگی به سرویس باید در تصمیم استفاده از ابر بررسی شوند.
استقرار مدل
مدل آموزشدیده باید در یک برنامه، گزارش یا سرویس پیشبینی استفاده شود. استقرار شامل آمادهسازی ورودی، اجرای مدل و تحویل خروجی به سیستم دیگر است.
نسخه مدل و مراحل پردازش داده باید ثبت شوند تا نتیجه قابل بازتولید و عیبیابی باشد.
پایش مدل
عملکرد مدل ممکن است با تغییر رفتار کاربران یا شرایط محیط کاهش یابد. پایش کیفیت داده، توزیع ویژگیها و خطاهای پیشبینی برای حفظ عملکرد ضروری است.
مدلهای عملیاتی باید در صورت تغییر معنادار داده، بازبینی یا دوباره آموزش داده شوند.
اخلاق و حریم خصوصی داده
جمعآوری و استفاده از داده باید با هدف مشخص، حداقل دسترسی و رعایت حریم خصوصی انجام شود. وجود داده بهتنهایی مجوز استفاده نامحدود از آن نیست.
سوگیری داده میتواند به تصمیمهای ناعادلانه منجر شود؛ بنابراین عملکرد مدل باید برای گروههای مختلف بررسی شود.
ابزارهای رایج در مسیر علم داده
صفحه گسترده: برای بررسی اولیه و تحلیل مجموعهدادههای کوچک.
SQL: برای استخراج و ترکیب دادههای ذخیرهشده در پایگاههای رابطهای.
Python: برای پاکسازی، تحلیل، مصورسازی و ساخت مدلهای یادگیری ماشین.
R: برای تحلیل آماری و پژوهشهای دادهمحور.
دفترچههای محاسباتی: برای ترکیب کد، توضیح و خروجی در یک محیط قابل بررسی.
ابزارهای داشبورد: برای ارائه شاخصها و گزارشهای تعاملی به کاربران.
هدف کتاب وابسته کردن خواننده به یک ابزار واحد نیست؛ بلکه ایجاد درکی است که بتوان بر اساس نوع مسئله، ابزار مناسب را انتخاب کرد.
کاربردهای علم داده در دنیای واقعی
فروش و بازاریابی
تحلیل رفتار مشتری، بخشبندی مخاطبان، پیشبینی فروش و اندازهگیری کمپینها از کاربردهای رایج علم داده در بازاریابی هستند.
بانکداری و مالی
شناسایی تقلب، ارزیابی ریسک، تحلیل تراکنش و پیشبینی جریان مالی با روشهای دادهمحور انجام میشوند.
سلامت و پزشکی
دادههای پزشکی برای پژوهش، پایش بیمار و پشتیبانی از تصمیم درمانی استفاده میشوند. امنیت و محرمانگی در این حوزه اهمیت ویژهای دارد.
تولید و صنعت
تحلیل حسگرها میتواند خرابی تجهیزات را پیشبینی کند و به کاهش توقف خط تولید کمک نماید.
حملونقل
بهینهسازی مسیر، پیشبینی زمان رسیدن و مدیریت ناوگان از کاربردهای تحلیل داده در حملونقل هستند.
فروشگاههای اینترنتی
سیستم پیشنهاد محصول، پیشبینی موجودی و تحلیل سفر مشتری از دادههای رفتاری و تراکنشی استفاده میکنند.
شبکههای اجتماعی
تحلیل متن، روندها و تعامل کاربران برای شناخت موضوعات مهم و ارزیابی بازخورد مخاطبان کاربرد دارد.
مهارتهایی که با مطالعه این کتاب تقویت میشوند
تعریف مسئله دادهمحور: تبدیل یک نیاز واقعی به پرسشی قابل اندازهگیری.
شناخت کیفیت داده: تشخیص نقص، تکرار، ناسازگاری و سوگیری.
درک آمار پایه: تفسیر شاخصهای توصیفی، احتمال و روابط میان متغیرها.
انتخاب روش تحلیلی: تشخیص تفاوت رگرسیون، طبقهبندی، خوشهبندی و تحلیل اکتشافی.
ارزیابی مدل: استفاده از داده آزمایشی و معیار متناسب با هدف.
مصورسازی و ارتباط: تبدیل نتیجه فنی به نمودار و توضیح قابل فهم.
تفکر انتقادی: پرسش درباره منبع داده، فرضیات و محدودیت نتیجه.
کتاب Data Science For Dummies برای چه کسانی مناسب است؟
افراد مبتدی
افرادی که هیچ تجربه جدی در علم داده ندارند میتوانند از این کتاب برای شناخت واژگان، مراحل و کاربردهای اصلی استفاده کنند.
دانشجویان
دانشجویان رشتههای کامپیوتر، مدیریت، اقتصاد، مهندسی و علوم اجتماعی میتوانند دیدی مقدماتی درباره تحلیل داده به دست آورند.
مدیران و صاحبان کسبوکار
مدیران با مطالعه کتاب میتوانند فرصتها و محدودیتهای پروژههای دادهمحور را بهتر درک کنند و با تیمهای فنی ارتباط دقیقتری داشته باشند.
تحلیلگران کسبوکار
تحلیلگران میتوانند دانش خود را از گزارشگیری به سمت مدلسازی، ارزیابی و تفسیر پیشرفتهتر توسعه دهند.
برنامهنویسان تازهکار
برنامهنویسانی که قصد ورود به داده و یادگیری ماشین را دارند، با مطالعه این کتاب نقشه کلی مسیر را میشناسند.
علاقهمندان به تغییر مسیر شغلی
این منبع میتواند به افراد کمک کند پیش از انتخاب دوره تخصصی، نقشها و مهارتهای موردنیاز حوزه علم داده را بهتر بشناسند.
پیشنیازهای مطالعه کتاب
برای شروع مطالعه، آشنایی عمیق با برنامهنویسی یا ریاضیات پیشرفته ضروری نیست. درک مفاهیم پایه عدد، جدول و نمودار برای دنبال کردن بخشهای مقدماتی کافی است.
برای اجرای پروژههای عملی، یادگیری تدریجی Python، SQL و آمار پایه میتواند مفید باشد. کتاب دید کلی ایجاد میکند و مسیر مطالعه تخصصیتر را روشنتر میسازد.
نکته درباره نسخهها و ابزارهای نرمافزاری
عنوان Data Science For Dummies در نسخههای مختلف منتشر شده است و ابزارها و رابطهای نرمافزاری نیز در طول زمان تغییر میکنند. محصول حاضر بر اساس فایل ثبتشده در فروشگاه ارائه میشود و در اطلاعات محصول، ویرایش یا سال انتشار مشخص نشده است.
هنگام اجرای مثالهای نرمافزاری بهتر است نسخه ابزار مورد استفاده در کتاب با مستندات جدید مقایسه شود. با این حال، اصولی مانند تعریف مسئله، کیفیت داده، ارزیابی و تفسیر نتیجه ماندگاری بیشتری دارند.
چرا مطالعه Data Science For Dummies مفید است؟
علم داده حوزهای گسترده است و ورود بدون نقشه راه میتواند گیجکننده باشد. این کتاب مفاهیم اصلی را در یک چارچوب منظم ارائه میدهد و ارتباط میان آمار، داده، الگوریتم و تصمیمگیری را روشن میکند.
خواننده پس از مطالعه بهتر میتواند تشخیص دهد کدام بخش از علم داده با علاقه و هدف او هماهنگ است و برای ادامه مسیر به چه مهارتهایی نیاز دارد.
این کتاب همچنین به مخاطب کمک میکند ادعاهای دادهمحور را انتقادیتر بررسی کند و میان نتیجه واقعی، همبستگی ظاهری و پیشبینی غیرقابل اعتماد تفاوت قائل شود.
نسخه انگلیسی کتاب Data Science For Dummies با فرمت PDF
محصول حاضر شامل نسخه انگلیسی کتاب Data Science For Dummies با فرمت PDF است. فایل PDF را میتوان در رایانه، لپتاپ، تبلت و تلفن همراه مطالعه کرد.
مطالعه نسخه انگلیسی به خواننده کمک میکند واژگان تخصصی علم داده، آمار و یادگیری ماشین را به زبان اصلی بشناسد و برای استفاده از مستندات، دورهها و منابع بینالمللی آمادهتر شود.
جمعبندی معرفی کتاب Data Science For Dummies
کتاب Data Science For Dummies نسخه انگلیسی PDF منبعی مناسب برای آشنایی مقدماتی با چرخه علم داده، آمار، پاکسازی اطلاعات، تحلیل اکتشافی، یادگیری ماشین، مصورسازی، ارزیابی مدل و اخلاق داده است.
اگر میخواهید بدون ورود ناگهانی به جزئیات پیچیده، تصویری روشن از علم داده و کاربردهای آن به دست آورید، این کتاب میتواند نقطه شروع مناسبی برای مسیر یادگیری شما باشد.



نقد و بررسیها
هنوز بررسیای ثبت نشده است.