
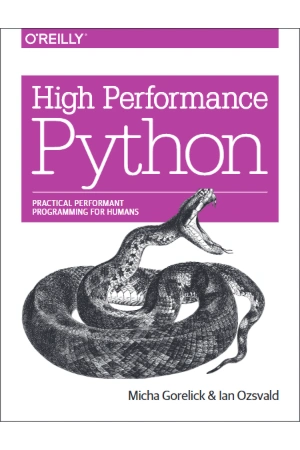
کتاب پایتون با کارایی بالا اثر میکا گورلیک و ایان آزوالد نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- حجم فایل: 7.6 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب High Performance Python اثر Micha Gorelick و Ian Ozsvald
High Performance Python اثر Micha Gorelick و Ian Ozsvald یکی از منابع شناختهشده برای بهینهسازی برنامههای Python و درک Bottleneckهای واقعی Performance است. فایل این محصول به زبان انگلیسی ثبت شده و موضوع آن صرفاً «سریعتر نوشتن کد» نیست؛ بلکه به Profiling، ساختار داده، محاسبات عددی، Parallelism، Memory و انتخاب ابزار مناسب برای هر مسئله میپردازد.
Python به دلیل سادگی و سرعت توسعه محبوب است، اما در پروژههای سنگین ممکن است محدودیت Interpreter، حافظه یا I/O آشکار شود. این کتاب نشان میدهد پیش از هر Optimization باید اندازهگیری کرد و دقیقاً فهمید زمان یا حافظه کجا مصرف میشود.
اول اندازهگیری، بعد بهینهسازی
یکی از مهمترین اصول Performance Engineering این است که بدون Profiling نباید حدس زد. بخشی از کد که از نظر بصری پیچیده به نظر میرسد الزاماً Bottleneck واقعی نیست. ابزارهای Timing و Profiler کمک میکنند Hot Path برنامه شناسایی شود.
Time Complexity و هزینه واقعی
درک Big-O برای انتخاب Algorithm اهمیت دارد، اما Performance عملی فقط به Complexity وابسته نیست. Cache، Memory Allocation، Python Object Overhead و Library Implementation نیز اثر دارند.
گاهی تعویض یک Algorithm نتیجه بسیار بزرگتری از Micro-optimization روی Syntax ایجاد میکند.
ساختار داده مناسب
List، Tuple، Set و Dictionary رفتار Performance متفاوتی دارند. جستوجوی Membership در Set معمولاً از List سریعتر است و Dictionary برای Lookup کلید طراحی شده است.
انتخاب ساختار داده باید بر اساس الگوی دسترسی انجام شود؛ سرعت Insert، Lookup، Iteration و Memory همگی مهماند.
Iterator و Generator
Generatorها اجازه میدهند داده به شکل Lazy تولید شود و نیاز به نگهداری همه عناصر در حافظه نباشد. این ویژگی برای Stream یا Dataset بزرگ ارزشمند است.
استفاده از Generator میتواند Peak Memory را کاهش دهد، هرچند در بعضی سناریوها Materialize کردن داده برای استفاده چندباره مناسبتر است.
NumPy و Vectorization
برای محاسبات عددی بزرگ، Loop سطح Python معمولاً کند است. NumPy عملیات را روی Array و در لایههای کامپایلشده اجرا میکند و میتواند Performance را به شکل محسوسی افزایش دهد.
Vectorization باید با توجه به Memory انجام شود، زیرا ساخت Arrayهای موقت بزرگ ممکن است Bottleneck جدید ایجاد کند.
Memory Usage
هر Object در Python علاوه بر داده، Metadata و Reference دارد. میلیونها Object کوچک میتوانند حافظه زیادی مصرف کنند.
کتاب کمک میکند تفاوت میان ساختارهای فشرده عددی و Objectهای Python را بفهمیم و در Dataset بزرگ انتخاب بهتری داشته باشیم.
Cache و Locality
سرعت CPU بسیار بیشتر از Memory است و نحوه دسترسی به داده روی Performance اثر میگذارد. داده Contiguous معمولاً برای Cache مناسبتر از ساختارهای پراکنده است.
این موضوع در NumPy، پردازش Matrix و Loopهای عددی اهمیت زیادی دارد.
Multiprocessing
برای Taskهای CPU-bound، محدودیت GIL در CPython باعث میشود Threadها همیشه مقیاسپذیری مورد انتظار ایجاد نکنند. Multiprocessing میتواند از چند Core واقعی استفاده کند.
اما Process هزینه Serialization، Memory و Communication دارد؛ بنابراین برای Task کوچک ممکن است کندتر از اجرای ساده باشد.
Threading
Threadها برای بسیاری از کارهای I/O-bound مانند Network و File مفید هستند، زیرا هنگام انتظار I/O میتوان Task دیگری اجرا کرد.
در کار CPU-bound باید رفتار GIL و Libraryهای مورد استفاده بررسی شود؛ بعضی Extensionهای C هنگام محاسبه GIL را آزاد میکنند.
Asynchronous I/O
در سیستمهایی با تعداد زیادی Connection یا عملیات انتظار، Async میتواند Concurrency بالا با Thread کمتر ایجاد کند. معماری Event Loop برای Serverها و Network Clientها کاربرد دارد.
Async جایگزین خودکار Multiprocessing نیست؛ مسئله CPU-bound و I/O-bound باید از هم تفکیک شوند.
Cython
Cython اجازه میدهد بخشی از کد Python به C نزدیک شود و Type Information اضافه گردد. در Loopهای عددی خاص میتواند سرعت زیادی ایجاد کند.
هزینه آن افزایش Complexity Build و کاهش سادگی کد است؛ بنابراین باید فقط برای Bottleneck واقعی استفاده شود.
Numba و JIT
در اکوسیستم مدرن، ابزارهای JIT مانند Numba نیز برای شتاب دادن Functionهای عددی کاربرد دارند. هرچند بسته به ویرایش کتاب ممکن است پوشش آن محدود باشد، ایده اصلی ثابت است: بخش Hot Code را به اجرای بهینهتر منتقل کنیم.
Database و I/O
گاهی کندی برنامه ربطی به Python ندارد و Query دیتابیس، Network یا Disk عامل اصلی است. Optimization باید کل سیستم را ببیند.
Batch کردن درخواستها، Index مناسب و کاهش Round-trip میتواند اثر بیشتری از تغییر Algorithm داخل Python داشته باشد.
Profiling حافظه
Memory Leak یا Growth تدریجی میتواند Production را ناپایدار کند. ابزارهای Memory Profiling کمک میکنند Allocationهای بزرگ و Objectهای باقیمانده شناسایی شوند.
Peak Memory نیز مهم است؛ برنامهای که متوسط مصرف کمی دارد اما ناگهان RAM زیادی میخواهد ممکن است در Container محدود Fail شود.
Benchmark درست
Benchmark باید Reproducible باشد و Warm-up، Noise سیستم و اندازه Dataset را در نظر بگیرد. یک اجرای منفرد معیار خوبی نیست.
همچنین باید Performance را در شرایطی مشابه Production اندازهگیری کرد.
Trade-off میان سرعت و خوانایی
کد سریع اما بسیار پیچیده هزینه Maintenance ایجاد میکند. Optimization باید ارزش واقعی داشته باشد و Documentation مناسب همراه آن باشد.
اگر یک Bottleneck فقط 2 درصد زمان کل را مصرف میکند، دو برابر سریع کردن آن اثر نهایی کمی دارد.
محدودیت نسخه کتاب
اکوسیستم Python از زمان انتشار ویرایشهای اولیه High Performance Python تغییر کرده است. نسخههای جدید Interpreter، NumPy، asyncio و ابزارهای Profiling بهبود یافتهاند.
با این حال اصول کتاب همچنان معتبرند: اندازهگیری، انتخاب Algorithm مناسب، مدیریت حافظه، استفاده درست از Parallelism و انتقال Hot Path به ابزار مناسب.
این کتاب برای چه کسانی مناسب است؟
- توسعهدهندگان Python که با Performance مشکل دارند.
- مهندسان Data Science و Scientific Computing.
- Backend Developerهایی که Latency و Throughput برایشان مهم است.
- افرادی که میخواهند GIL، Multiprocessing و Memory را عمیقتر بفهمند.
- برنامهنویسانی که به Profiling و Benchmark حرفهای علاقه دارند.
جمعبندی
High Performance Python اثر Micha Gorelick و Ian Ozsvald کتابی درباره مهندسی Performance در Python است. موضوعات آن از Profiling و Data Structure شروع میشوند و به NumPy، Memory، Concurrency، Multiprocessing و Optimization سطح پایینتر میرسند.
پیام اصلی اثر ساده اما مهم است: ابتدا Bottleneck را اندازهگیری کنید و سپس دقیقاً همان بخش را بهینه کنید. برای توسعهدهندهای که میخواهد Python را در پروژههای سنگینتر و Production با دید مهندسی استفاده کند، این کتاب منبع ارزشمندی است.




نقد و بررسیها
هنوز بررسیای ثبت نشده است.