
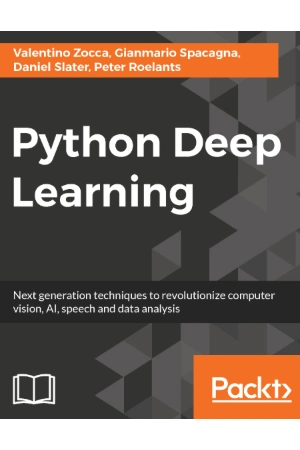

کتاب یادگیری عمیق با پایتون نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- حجم فایل: 5.01 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب Python Deep Learning
Python Deep Learning اثر Valentino Zocca، Gianmario Spacagna، Daniel Slater و Peter Roelants یک منبع عملی برای آشنایی با یادگیری عمیق و پیادهسازی مدلهای عصبی با Python است. این کتاب در دورهای منتشر شده که اکوسیستم Deep Learning با سرعت زیادی در حال رشد بود و ابزارهایی مانند TensorFlow، Theano و Keras نقش مهمی در آموزش و آزمایش شبکههای عصبی داشتند. به همین دلیل، ارزش اصلی اثر را باید در مفاهیم، شیوه طراحی Experiment و درک معماریهای عصبی دید؛ برخی APIها و Syntaxهای تاریخی آن ممکن است امروز نیاز به تطبیق با نسخههای جدید کتابخانهها داشته باشند.
برای خوانندهای که از Machine Learning کلاسیک وارد Deep Learning میشود، مهمترین تغییر این است که Feature Engineering تا حدی جای خود را به Representation Learning میدهد. شبکه عمیق میتواند از داده خامتر، نمایشهای چندلایهای یاد بگیرد؛ اما این توانایی به Data مناسب، طراحی درست Loss، Optimization، Regularization و Evaluation وابسته است. کتاب بهجای ارائه Deep Learning بهعنوان یک جعبه سیاه، مسیر ساخت مدل و تحلیل رفتار آن را به شکل عملی دنبال میکند.
یادگیری عمیق چیست؟
Deep Learning شاخهای از Machine Learning است که از شبکههای عصبی چندلایه برای یادگیری Representationهای پیچیده استفاده میکند. هر لایه Transformationی روی داده انجام میدهد و لایههای بعدی میتوانند Patternهای سطح بالاتری را از خروجی لایههای قبلی استخراج کنند.
در پردازش تصویر، لایههای اولیه ممکن است Edge و Texture را یاد بگیرند و لایههای بالاتر Shape یا Object را تشخیص دهند. در متن و Sequence نیز Representation از Tokenها به الگوهای معنایی یا زمانی پیچیدهتر حرکت میکند.
Neuron و شبکه عصبی
واحد پایه شبکه عصبی ورودیها را با Weightهای قابل یادگیری ترکیب میکند، Bias را اضافه میکند و نتیجه را از Activation Function عبور میدهد. با اتصال تعداد زیادی از این واحدها میتوان Functionهای بسیار پیچیده را تقریب زد.
نکته مهم این است که قدرت شبکه فقط از تعداد Neuronها نمیآید. Architecture، Data، Loss، Initialization و Optimization همگی رفتار یادگیری را تعیین میکنند.
لایههای شبکه
شبکه معمولاً شامل Input Layer، یک یا چند Hidden Layer و Output Layer است. Input شکل داده را دریافت میکند، Hidden Layerها Representation میسازند و Output بر اساس Task طراحی میشود.
برای Classification چندکلاسه معمولاً خروجی با تعداد Classها هماهنگ میشود، در حالی که Regression ممکن است یک یا چند مقدار پیوسته تولید کند.
Activation Function
اگر همه لایهها فقط Transformation خطی باشند، ترکیب آنها نیز در نهایت خطی خواهد بود. Activation غیرخطی به شبکه اجازه میدهد Boundary و Functionهای پیچیدهتر را مدل کند.
Sigmoid و tanh از Activationهای تاریخی مهم هستند و ReLU در شبکههای عمیق به دلیل رفتار ساده و Gradient مناسبتر بسیار رایج شد. انتخاب Activation باید با Architecture و نوع Output هماهنگ باشد.
Forward Propagation
در Forward Pass داده از لایه ورودی به سمت خروجی حرکت میکند. هر Layer با Parameterهای فعلی Transformation انجام میدهد تا Prediction ساخته شود.
در Training، این Prediction با Target مقایسه میشود تا مقدار Loss به دست آید.
Loss Function
Loss مشخص میکند Model چقدر از هدف فاصله دارد. Cross-Entropy برای بسیاری از مسائل Classification و Mean Squared Error برای برخی مسائل Regression رایجاند.
انتخاب Loss فقط یک تصمیم فنی کوچک نیست. چیزی که Model Optimize میکند همان Objective تعریفشده است؛ اگر Objective با هدف واقعی مسئله هماهنگ نباشد، Training خوب نیز نتیجه مطلوب نمیدهد.
Backpropagation
Backpropagation با استفاده از Chain Rule مشتق Loss نسبت به Parameterهای شبکه را محاسبه میکند. سپس Optimizer از این Gradient برای Update کردن Weightها استفاده میکند.
فهم Backpropagation برای تحلیل مشکلاتی مانند Vanishing Gradient، Exploding Gradient یا Learning کند اهمیت دارد، حتی اگر Framework تمام مشتقها را بهصورت خودکار محاسبه کند.
Gradient Descent
Gradient Descent تلاش میکند با حرکت در جهت کاهش Loss Parameterها را بهبود دهد. در Dataset بزرگ معمولاً از Mini-batch استفاده میشود تا هر Update بر اساس بخشی از داده انجام شود.
Batch Size و Learning Rate از مهمترین Hyperparameterها هستند و روی Stability، سرعت و Generalization اثر میگذارند.
Learning Rate
Learning Rate بیش از حد بزرگ میتواند باعث نوسان یا واگرایی Training شود و مقدار بسیار کوچک Training را کند میکند. Schedulerها یا روشهای Adaptive میتوانند مقدار مؤثر Step را در طول آموزش تنظیم کنند.
Optimizerها
SGD پایه مهمی برای Optimization است. روشهایی مانند Momentum، RMSProp و Adam تلاش میکنند جهت و Scale Updateها را بهتر مدیریت کنند.
Optimizer قوی جای Data و Architecture درست را نمیگیرد. بهتر است با Baseline ساده شروع و سپس تغییرات با Experiment کنترلشده مقایسه شوند.
Initialization
Weight Initialization نامناسب میتواند Gradient را در لایهها خیلی کوچک یا بزرگ کند. Initializationهای متناسب با Activation و Fan-in/Fan-out برای Training پایدارتر توسعه یافتهاند.
این موضوع نشان میدهد Deep Learning مجموعهای از جزئیات بههمپیوسته است و یک انتخاب کوچک میتواند رفتار کل شبکه را تغییر دهد.
Vanishing Gradient
در شبکه عمیق، Gradient ممکن است هنگام حرکت به لایههای اولیه بسیار کوچک شود. در این وضعیت Layerهای ابتدایی آهسته یاد میگیرند.
Activation، Initialization و معماریهای جدیدتر برای کاهش این مشکل اهمیت دارند.
Exploding Gradient
در طرف مقابل، Gradient میتواند بسیار بزرگ شود و Training را ناپایدار کند. Gradient Clipping یکی از روشهای رایج برای کنترل این مشکل، بهخصوص در شبکههای ترتیبی، است.
Overfitting
مدل با ظرفیت بالا میتواند Training Data را حفظ کند بدون اینکه روی داده جدید Generalize شود. اختلاف زیاد میان Training و Validation Performance نشانهای مهم است.
Data بیشتر، Regularization، Augmentation و کنترل Capacity از راههای مقابله با Overfitting هستند.
Regularization
L1 و L2 Weightها را محدود میکنند و Dropout بهصورت تصادفی بخشی از Activationها را هنگام Training حذف میکند. هدف جلوگیری از وابستگی بیش از حد Model به Patternهای خاص Training Set است.
Dropout
Dropout در Training شبکههای متفاوتی را به شکل ضمنی ایجاد میکند و میتواند Co-adaptation را کاهش دهد. هنگام Inference رفتار آن متفاوت است و Framework این تفاوت را مدیریت میکند.
Batch Normalization
Batch Normalization یکی از تکنیکهایی است که Training شبکههای عمیق را در بسیاری از Architectureها پایدارتر و سریعتر کرده است. رفتار Training و Inference آن باید تفکیک شود.
Dataset Split
Train، Validation و Test نقشهای متفاوت دارند. Training برای یادگیری Parameterها، Validation برای انتخاب Model و Hyperparameter و Test برای ارزیابی نهایی استفاده میشود.
استفاده مکرر از Test برای تصمیمگیری باعث Leakage مفهومی و خوشبینی در Estimate نهایی میشود.
Data Leakage
Scaling، Feature Extraction یا Augmentation نباید اطلاعاتی از Test وارد Training کنند. Leakage میتواند Accuracy بسیار بالا اما غیرواقعی بسازد.
Classification
در Classification هدف پیشبینی Class است. Output Layer و Loss باید با Binary یا Multiclass بودن مسئله سازگار باشند.
Accuracy برای داده نامتوازن کافی نیست و Precision، Recall، F1 و Confusion Matrix میتوانند تصویر دقیقتری بدهند.
Regression
در Regression خروجی عددی پیوسته است. Scale Target، Loss و Outlierها روی نتیجه اثر دارند.
MAE و MSE Errorها را متفاوت وزن میدهند و باید بر اساس کاربرد انتخاب شوند.
Convolutional Neural Networks
CNN برای دادههایی مانند Image طراحی شده که ساختار مکانی دارند. Convolution Kernel را روی نواحی مختلف حرکت میدهد و Weight Sharing تعداد Parameterها را کاهش میدهد.
این Architecture اجازه میدهد Featureهای محلی در Positionهای مختلف تشخیص داده شوند.
Convolution
هر Filter Pattern خاصی را در Feature Map استخراج میکند. در Layerهای اولیه ممکن است Edge و Texture و در لایههای بالاتر Structureهای پیچیدهتر شکل بگیرند.
Pooling
Pooling ابعاد Spatial را کاهش میدهد و تا حدی نسبت به تغییرات کوچک Position مقاومت ایجاد میکند. Max Pooling یکی از روشهای رایج تاریخی است.
Image Classification
برای Classification تصویر باید ورودی به Tensor مناسب تبدیل شود، Pixelها Normalize شوند و Labelها با Output هماهنگ باشند.
Evaluation باید روی Imageهایی انجام شود که Model در Training ندیده است.
Data Augmentation
Rotation، Flip، Crop یا Transformهای منطقی میتوانند تنوع داده تصویری را افزایش دهند. Augmentation باید Label را حفظ کند؛ Transformation نامناسب ممکن است Meaning نمونه را عوض کند.
Transfer Learning
استفاده از Network از پیشآموزشدیده میتواند نیاز به Dataset بسیار بزرگ را کاهش دهد. Featureهای عمومیتر Layerهای اولیه برای Task جدید قابل استفادهاند.
Freeze یا Fine-tune کردن Layerها باید با Size Dataset و فاصله Domain هماهنگ باشد.
Recurrent Neural Networks
RNN برای Sequence طراحی شده و Hidden State را از Step قبلی به Step بعدی منتقل میکند. این Memory ساده اجازه میدهد ترتیب داده در Prediction اثر داشته باشد.
Sequence Data
Text، Time Series، Audio و Sensor Stream نمونه داده ترتیبی هستند. در این مسائل Shuffle و Split باید با ساختار زمانی هماهنگ باشند.
LSTM
LSTM با Cell State و Gateها برای حفظ Dependencyهای طولانیتر توسعه یافته است. Forget، Input و Output Gate جریان اطلاعات را کنترل میکنند.
این معماری سالها یکی از ابزارهای اصلی Sequence Modeling بود و هنوز برای فهم تاریخ Deep Learning مهم است.
GRU
GRU ساختار Gate سادهتری نسبت به LSTM دارد و در بعضی Taskها Performance مشابه با Parameter کمتر ارائه میدهد.
Text Representation
متن باید به Representation عددی تبدیل شود. One-hot و Embedding دو رویکرد مهماند. Embedding به Tokenها Vector dense اختصاص میدهد که میتواند Relationهای معنایی را یاد بگیرد.
Word Embeddings
Embeddingهای Pretrained یا Learned بخشی مهم از NLP پیش از Transformerها بودند. Vectorهای نزدیک میتوانند Wordهای دارای Context مشابه را نشان دهند.
Sentiment Analysis
Classification احساس نمونهای از کاربرد شبکههای ترتیبی و Embedding است. Tokenization، Vocabulary و Length Sequence روی عملکرد اثر دارند.
Autoencoder
Autoencoder تلاش میکند Input را پس از عبور از Representation فشرده بازسازی کند. این Architecture برای Representation Learning، Denoising و Dimensionality Reduction کاربرد دارد.
Encoder و Decoder
Encoder داده را به Latent Representation تبدیل و Decoder آن را بازسازی میکند. کیفیت Latent Space به Objective و Architecture وابسته است.
Generative Models
مدلهای مولد تلاش میکنند Distribution داده را یاد بگیرند و نمونه جدید بسازند. کتاب متعلق به دورهای پیش از مدلهای Diffusion و LLMهای امروزی است، اما ایده Generative Learning پایهای مهم است.
Representation Learning
یکی از نقاط قوت Deep Learning توانایی یادگیری Featureها از Data است. با این حال Representation آموختهشده ممکن است Bias یا Artifact Dataset را نیز جذب کند.
Visualization
رسم Loss و Metric در طول Epochها یکی از سادهترین روشهای Debug است. Divergence میان Train و Validation میتواند Overfitting را نشان دهد.
Confusion Matrix
برای Classification، Confusion Matrix مشخص میکند Model کدام Classها را با هم اشتباه میگیرد. این اطلاعات از Accuracy کلی مفیدتر است.
Precision و Recall
در مسائل پزشکی، Fraud یا Detection نامتوازن، هزینه False Positive و False Negative یکسان نیست. Precision و Recall این تفاوت را بهتر نشان میدهند.
Hyperparameter Tuning
تعداد Layer، Width، Learning Rate، Batch Size و Regularization باید روی Validation انتخاب شوند. تغییر همزمان تعداد زیادی Parameter تحلیل نتیجه را دشوار میکند.
Baseline
قبل از شبکه پیچیده باید Baseline ساده ساخت. اگر Deep Model از Logistic Regression یا Tree بهتر نیست، Complexity اضافه نیازمند توجیه است.
Reproducibility
Seed، Dataset Version، preprocessing، Hyperparameter و Library Version باید ثبت شوند. GPU و بعضی Operationها ممکن است Determinism کامل نداشته باشند.
GPU Computing
Training شبکههای عمیق به عملیات ماتریسی گسترده نیاز دارد و GPU میتواند آن را تسریع کند. استفاده از GPU نیازمند مدیریت Memory و Batch Size مناسب است.
Performance و Memory
Model بزرگتر همیشه بهتر نیست. Parameter Count، Activation Memory و Latency روی امکان Deployment اثر دارند.
Inference
در Production فقط Training Speed مهم نیست. Inference Latency، Throughput و Memory نیز باید اندازهگیری شوند.
Model Serialization
برای استفاده بعدی باید Weightها و Configuration لازم ذخیره شوند. تفاوت Version Library میتواند Loading مدلهای قدیمی را دشوار کند.
Monitoring پس از Deployment
Distribution داده میتواند تغییر کند. Modelی که امروز خوب است ممکن است با Data Drift ضعیف شود.
Monitoring باید Error، Input Distribution و Business Metric مرتبط را دنبال کند.
Bias در داده
شبکه Patternهای موجود در Training Data را یاد میگیرد. اگر Dataset نماینده Population واقعی نباشد، Performance گروهها میتواند متفاوت باشد.
Explainability
Deep Network معمولاً از Modelهای خطی دشوارتر تفسیر میشود. Visualization Feature، Attribution و تحلیل Error میتوانند در فهم رفتار کمک کنند.
نسخههای تاریخی Frameworkها
یکی از نکات مهم در مطالعه Python Deep Learning این است که اکوسیستم نرمافزاری آن با وضعیت امروز تفاوت دارد. APIهای TensorFlow، Keras، Theano و Libraryهای مرتبط در طول سالها تغییر کردهاند و برخی ابزارهای قدیمی دیگر انتخاب اصلی نیستند.
بنابراین بهتر است Reader منطق Model و Workflow را از کتاب بگیرد و برای اجرای مثالها Syntax را با Documentation نسخه فعلی Framework مورد استفاده تطبیق دهد.
ارتباط با Deep Learning امروز
Transformer، Diffusion Model و Foundation Modelها بخش بزرگی از Landscape امروز را تغییر دادهاند، اما اصولی مانند Loss، Gradient، Regularization، Validation و Representation Learning همچنان پابرجا هستند.
چگونه کتاب را مطالعه کنیم؟
هر Architecture را ابتدا روی Dataset کوچک اجرا کنید. Curveهای Train و Validation را بررسی و سپس فقط یک Hyperparameter را تغییر دهید.
پس از گرفتن Baseline، Errorها را دستهبندی کنید. این روش یادگیری بسیار ارزشمندتر از اجرای مستقیم Model پیچیده و گزارش یک Accuracy است.
پیشنیازها
آشنایی با Python، جبر خطی پایه، احتمال مقدماتی و Machine Learning مطالعه را آسانتر میکند. برای بخش Optimization دانستن مفهوم مشتق و Gradient مفید است.
این کتاب برای چه کسانی مناسب است؟
- برنامهنویسان Python که میخواهند وارد Deep Learning شوند.
- دانشجویان Machine Learning و Data Science.
- افرادی که میخواهند CNN، RNN و LSTM را در عمل بفهمند.
- توسعهدهندگانی که با Frameworkهای قدیمیتر Deep Learning روبهرو هستند و میخواهند مفاهیم را از Syntax جدا کنند.
- خوانندگانی که آموزش پروژهمحور را در کنار مبانی نظری ترجیح میدهند.
جمعبندی
Python Deep Learning اثر Valentino Zocca، Gianmario Spacagna، Daniel Slater و Peter Roelants مسیری عملی برای شناخت شبکههای عصبی و معماریهای مهم یادگیری عمیق فراهم میکند. Training، Backpropagation، Optimization، Regularization، CNN، RNN، LSTM، Embedding و Representation Learning از موضوعاتی هستند که برای ساخت یک پایه عملی اهمیت دارند.
بخشهایی از ابزارها و APIهای کتاب متعلق به نسل قدیمیتر اکوسیستم Python هستند، اما این موضوع ارزش مفاهیم اصلی را از بین نمیبرد. اگر مثالها با Libraryهای امروزی تطبیق داده شوند، کتاب همچنان میتواند به Reader کمک کند بفهمد یک Deep Model چگونه ساخته، آموزش، ارزیابی و Debug میشود و چرا کیفیت داده و Evaluation به اندازه انتخاب Architecture اهمیت دارند.




نقد و بررسیها
هنوز بررسیای ثبت نشده است.