
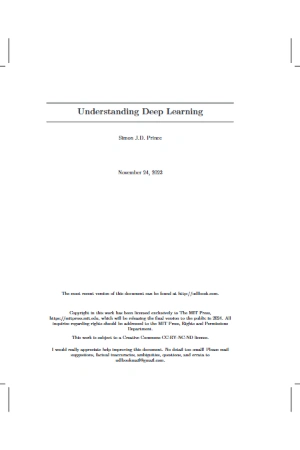

کتاب درک یادگیری عمیق اثر سایمون پرینس نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 541 صفحه
- حجم فایل: 21.28 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب Understanding Deep Learning اثر Simon J. D. Prince
کتاب Understanding Deep Learning نوشته Simon J. D. Prince یکی از منابع معاصر و جامع برای یادگیری مفاهیم اصلی Deep Learning است. این اثر توسط MIT Press در سال 2023 منتشر شده و هدف آن ایجاد تعادل میان شهود، ریاضیات و پیادهسازی عملی است. نویسنده تلاش میکند مفاهیم پیچیده را ابتدا با توضیح قابل فهم و نمودارهای بصری معرفی کند، سپس آنها را با فرمول دقیقتر کند و در نهایت زمینهای برای پیادهسازی و آزمایش عملی فراهم آورد.
نسخه رسمی کتاب 544 صفحه دارد و فایل موجود در این محصول 541 صفحه ثبت شده است. این اختلاف جزئی میتواند به شیوه شمارش صفحات PDF و صفحات ابتدایی مربوط باشد. موضوعات کتاب از یادگیری نظارتشده و شبکههای عصبی ساده آغاز میشوند و تا معماریهای مدرن مانند شبکههای کانولوشنی، Residual Networks، Transformers، Graph Neural Networks، مدلهای مولد و Diffusion Models پیش میروند. وجود تمرینهای متعدد و Notebookهای پایتون نیز باعث میشود کتاب صرفاً یک منبع نظری نباشد.
این کتاب درباره چیست؟
Deep Learning شاخهای از Machine Learning است که از مدلهای چندلایه برای یادگیری نمایشهای پیچیده از داده استفاده میکند. در سالهای اخیر این مدلها در بینایی ماشین، پردازش زبان طبیعی، تولید متن و تصویر، سیستمهای توصیهگر، زیستمحاسبات و بسیاری از حوزههای دیگر نقش مهمی پیدا کردهاند. اما تنوع معماریها و سرعت پیشرفت حوزه باعث میشود یادگیری آن برای تازهواردها گیجکننده باشد.
Understanding Deep Learning تلاش میکند به جای ارائه فهرستی از مدلها، اصول مشترکی را که پشت آنها قرار دارند روشن کند. خواننده ابتدا میآموزد یک مدل یادگیری نظارتشده چه کاری انجام میدهد، شبکه عصبی چگونه یک تابع پیچیده را تقریب میزند، Loss Function چه نقشی دارد و Gradient چگونه برای تنظیم پارامترها استفاده میشود. پس از تثبیت این پایه، معماریهای تخصصیتر معرفی میشوند.
شروع از مبانی Machine Learning
کتاب فرض نمیکند خواننده از ابتدا متخصص Deep Learning است. فصلهای اولیه به مفاهیم پایه Machine Learning و Supervised Learning اختصاص دارند. در یک مسئله نظارتشده، مجموعهای از ورودیها و خروجیهای صحیح در اختیار مدل قرار میگیرد و هدف یادگیری رابطهای است که بتواند برای نمونههای جدید پیشبینی مناسبی انجام دهد.
این نقطه شروع مهم است، زیرا شبکه عصبی در نهایت یک مدل پارامتری است. پیش از ورود به لایهها و معماریها باید بفهمیم مدل چه چیزی را یاد میگیرد، پارامتر چیست، Training Data چه نقشی دارد و عملکرد مدل چگونه اندازهگیری میشود. کتاب این مفاهیم را با نمودارهای متعدد توضیح میدهد تا رابطه هندسی و ریاضی آنها روشنتر شود.
شبکههای عصبی کمعمق و مفهوم Activation
پس از مبانی، شبکههای عصبی Shallow معرفی میشوند. در این مرحله خواننده میبیند که چگونه ترکیب چند واحد محاسباتی و Activation Function میتواند توابع غیرخطی را مدل کند. موضوعاتی مانند ReLU و سایر توابع فعالسازی در این بخش اهمیت پیدا میکنند.
نویسنده فقط فرمول Forward Pass را ارائه نمیکند، بلکه تلاش میکند نشان دهد شبکه چگونه فضای ورودی را به نواحی مختلف تقسیم میکند و چرا افزایش تعداد واحدها ظرفیت مدل را تغییر میدهد. این نگاه بصری به فهم مفهوم Representation کمک میکند؛ یکی از ایدههای مرکزی Deep Learning همین است که شبکه بهتدریج نمایش مناسبتری از داده یاد میگیرد.
از شبکه کمعمق تا Deep Neural Network
شبکه عمیق با ترکیب چندین لایه ساخته میشود. هر لایه خروجی لایه قبلی را دریافت و تبدیل میکند. در نگاه ساده، ممکن است تصور شود عمق فقط تعداد پارامترها را بیشتر میکند، اما کتاب توضیح میدهد ترکیب سلسلهمراتبی توابع چگونه ظرفیت نمایشی مدل را تغییر میدهد.
این بخش پایه لازم برای فهم معماریهای پیچیدهتر را میسازد. CNN، Transformer یا Residual Network همگی در نهایت مجموعهای از تبدیلها هستند که ساختار خاصی برای استفاده بهتر از ویژگیهای داده دارند. اگر خواننده مفهوم Composition و نقش لایهها را بفهمد، یادگیری معماریهای بعدی بسیار آسانتر میشود.
Loss Function؛ مدل چگونه میفهمد اشتباه کرده است؟
مدل برای یادگیری نیاز به معیاری دارد که فاصله خروجی فعلی با نتیجه مطلوب را اندازهگیری کند. این معیار Loss Function است. نوع Loss به مسئله وابسته است؛ Regression، Classification و مدلهای احتمالاتی میتوانند توابع هزینه متفاوتی داشته باشند.
کتاب رابطه میان مدل احتمالاتی و Loss را توضیح میدهد و کمک میکند خواننده فرمول را فقط به عنوان دستور حفظ نکند. انتخاب Loss روی رفتار Training اثر مستقیم دارد و بخشی از طراحی مدل محسوب میشود. شناخت این موضوع برای تشخیص مشکل در پروژههای واقعی نیز مهم است.
Optimization و Gradient Descent
پس از تعریف Loss، باید پارامترهای مدل طوری تغییر کنند که مقدار خطا کاهش یابد. Gradient Descent و نسخههای مختلف آن ابزار اصلی این فرایند هستند. کتاب مفهوم Gradient، جهت تغییر پارامتر و نقش Learning Rate را به شکل مرحلهای توضیح میدهد.
در شبکههای بزرگ، Optimization یک مسئله ساده و کاملاً قابل پیشبینی نیست. Learning Rate نامناسب، Initialization ضعیف یا شکل پیچیده فضای Loss میتواند Training را کند یا ناپایدار کند. کتاب این مسائل را در فصلهای مستقل بررسی میکند تا خواننده بداند مشکل عملکرد مدل همیشه از معماری نیست.
Backpropagation و محاسبه Gradient
Backpropagation یکی از بنیادیترین الگوریتمهای Deep Learning است. این روش با استفاده از Chain Rule مشتق Loss را نسبت به پارامترهای لایههای مختلف محاسبه میکند. در Frameworkهای مدرن این محاسبه معمولاً بهصورت خودکار انجام میشود، اما فهم منطق آن برای درک Training ضروری است.
Prince سعی میکند Backpropagation را نه به عنوان فرمولی جادویی، بلکه به عنوان جریان محاسبه Gradient در یک گراف محاسباتی توضیح دهد. این درک هنگام Debug کردن مدل، نوشتن عملیات سفارشی و تشخیص مشکلات Gradient مفید است.
Initialization، Regularization و Generalization
شبکهای که روی داده Training عملکرد عالی دارد الزاماً روی داده جدید خوب عمل نمیکند. این مسئله با مفهوم Generalization مرتبط است. کتاب موضوعاتی مانند Initialization، Regularization و روشهای بهبود عملکرد را برای کنترل Training و کاهش Overfitting بررسی میکند.
Regularization میتواند از طریق محدودسازی پارامترها، Data Augmentation، Dropout یا روشهای دیگر انجام شود. هدف ایجاد مدلی است که به جای حفظ کردن نمونههای آموزشی، الگوهای قابل تعمیم را یاد بگیرد. این موضوع یکی از مهمترین فاصلههای میان یک Demo موفق و مدل قابل استفاده در دنیای واقعی است.
Convolutional Neural Networks و بینایی ماشین
شبکههای کانولوشنی یا CNN برای دادههایی مانند تصویر طراحی شدهاند که ساختار مکانی دارند. به جای اتصال هر ورودی به هر واحد، Kernelهای کوچک روی تصویر حرکت میکنند و الگوهای محلی را استخراج میکنند. Shared Weights باعث کاهش تعداد پارامترها و استفاده بهتر از ساختار تصویر میشود.
کتاب CNN را از اصول کانولوشن آغاز میکند و سپس معماریهای عمیقتر را بررسی میکند. این بخش کمک میکند خواننده بفهمد چرا CNN برای تشخیص لبه، بافت، شکل و الگوهای پیچیده تصویری مناسب است و چگونه لایههای متوالی نمایشهای سطح بالاتر میسازند.
Residual Networks و حل مشکل آموزش شبکههای عمیق
با افزایش عمق شبکه، Training میتواند دشوار شود. Residual Connections یکی از نوآوریهای مهمی بودند که آموزش شبکههای بسیار عمیق را عملیتر کردند. در این ساختار، اطلاعات میتواند از طریق Skip Connection بخشی از لایهها را دور بزند.
کتاب توضیح میدهد چرا چنین اتصالهایی به جریان Gradient و یادگیری نگاشتهای مناسب کمک میکنند. مفهوم Residual Connection بعدها در معماریهای بسیاری فراتر از Computer Vision نیز استفاده شد و فهم آن برای مطالعه مدلهای مدرن اهمیت دارد.
Attention و Transformers
یکی از مهمترین بخشهای معاصر کتاب به Attention و Transformerها اختصاص دارد. Transformer معماری پایه بسیاری از مدلهای زبان بزرگ و سیستمهای مدرن پردازش توالی است. برخلاف RNNهای کلاسیک، Self-Attention اجازه میدهد هر موقعیت در توالی مستقیماً با موقعیتهای دیگر تعامل کند.
کتاب مفاهیمی مانند Dot-Product Attention، Scaled Attention، Multi-Head Attention، Position Encoding، Encoder و Decoder را توضیح میدهد. این ساختار کمک میکند خواننده از سطح استفاده از یک مدل آماده فراتر برود و بفهمد Transformer چگونه اطلاعات را میان Tokenها ترکیب میکند.
Transformerها چه چیزی را تغییر دادند؟
قدرت Transformer فقط به NLP محدود نمانده است. این معماری در Vision، Audio، Multimodal Learning و بسیاری از حوزههای دیگر به کار رفته است. Self-Attention انعطاف زیادی برای مدلسازی رابطه میان بخشهای مختلف داده ایجاد میکند.
برای خوانندهای که به LLMها علاقه دارد، فصل Transformer پایه ضروری ایجاد میکند. بدون شناخت Attention، درک موضوعاتی مانند Pretraining، Context، Encoder-Decoder و بسیاری از معماریهای جدید سطحی باقی میماند.
Graph Neural Networks
همه دادهها روی Grid یا Sequence قرار ندارند. شبکه اجتماعی، مولکول، مسیرهای حملونقل و بسیاری از سیستمها ساختار Graph دارند. Graph Neural Networks برای یادگیری روی چنین دادههایی طراحی شدهاند.
کتاب نشان میدهد چگونه اطلاعات میان Nodeهای مرتبط منتقل و ترکیب میشود. این مفهوم Message Passing یکی از پایههای بسیاری از GNNهاست. آشنایی با آن دید خواننده را از تصاویر و متن فراتر میبرد و نشان میدهد Deep Learning چگونه با ساختارهای داده متنوع سازگار میشود.
مدلهای مولد
مدلهای مولد تلاش میکنند توزیع داده را یاد بگیرند و نمونههای جدید تولید کنند. کتاب خانوادههای مختلف Generative Model را بررسی میکند و تفاوت دیدگاه آنها را توضیح میدهد. این موضوع برای فهم تولید تصویر، صدا و سایر دادههای مصنوعی ضروری است.
مدل مولد فقط برای ساخت محتوای جدید نیست. یادگیری توزیع میتواند در Representation Learning، تکمیل داده، تشخیص ناهنجاری و مسائل دیگر نیز کاربرد داشته باشد. کتاب تلاش میکند ارتباط میان مبانی احتمال و معماریهای مولد را روشن کند.
Variational Autoencoders و Latent Variables
VAEها با تعریف فضای Latent احتمالاتی، داده را به نمایش فشرده تبدیل و سپس از آن بازسازی میکنند. این ساختار امکان Sampling و تولید داده جدید را فراهم میکند. کتاب توضیح میدهد چگونه مفهوم Latent Variable، Encoder، Decoder و تقریب توزیع Posterior در کنار هم قرار میگیرند.
این فصل برای کسی که میخواهد مدلهای مولد را عمیقتر بفهمد مهم است، زیرا بسیاری از ایدههای احتمال و Representation در آن به شکل عملی کنار هم دیده میشوند.
Generative Adversarial Networks
GANها از رقابت دو شبکه استفاده میکنند: Generator تلاش میکند نمونههایی تولید کند که واقعی به نظر برسند و Discriminator تلاش میکند داده واقعی و مصنوعی را از هم تشخیص دهد. این بازی رقابتی میتواند به تولید نمونههای بسیار باکیفیت منجر شود.
در عین حال Training GAN به ناپایداری و مشکلاتی مانند Mode Collapse معروف است. کتاب علاوه بر ایده اصلی، محدودیتهای این خانواده را نیز بررسی میکند تا خواننده تصویر واقعبینانهتری از مدلهای مولد داشته باشد.
Diffusion Models؛ نسل جدید مدلهای تولیدی
یکی از نقاط قوت Understanding Deep Learning نسبت به بسیاری از کتابهای قدیمیتر، پوشش Diffusion Models است. این مدلها با افزودن تدریجی نویز به داده و سپس یادگیری فرایند معکوس، امکان تولید نمونههای جدید را ایجاد میکنند.
Diffusion Modelها در سالهای اخیر نقش مهمی در تولید تصویر داشتهاند. کتاب مبانی این روش را در کنار سایر مدلهای مولد قرار میدهد تا خواننده بتواند تفاوت رویکردها را بفهمد. این پوشش معاصر یکی از دلایلی است که کتاب برای مطالعه Deep Learning امروز مناسب است.
ارتباط نظریه و پیادهسازی
MIT Press کتاب را منبعی میان نظریه و عمل توصیف میکند. نویسنده وارد جزئیات مهندسی تمام Frameworkها نمیشود، اما به اندازهای از ریاضیات و الگوریتم توضیح میدهد که خواننده بتواند نسخه سادهای از مدل را پیادهسازی کند و منطق آن را بفهمد.
این رویکرد برای یادگیری عمیقتر مفید است. استفاده از PyTorch یا TensorFlow میتواند چند خط کد برای ساخت لایه فراهم کند، اما اگر ندانیم آن لایه چه محاسبهای انجام میدهد، هنگام خطا یا طراحی معماری جدید وابسته به API خواهیم ماند.
تمرینهای Python Notebook
وبسایت رسمی کتاب 68 تمرین Python Notebook برای بخشهای مختلف متن ارائه میکند. این Notebookها قسمتهایی از کد را خالی میگذارند تا خواننده بر اساس توضیحات کتاب آنها را کامل کند. چنین تمرینهایی مطالعه را از حالت منفعل خارج میکنند.
موضوع تمرینها از ریاضیات پایه و Supervised Learning آغاز میشود و به شبکههای عمیق و مدلهای پیشرفته میرسد. اگر هدف شما یادگیری واقعی است، بهتر است هر فصل را همراه با Notebook مربوط اجرا کنید و فقط پاسخ آماده را مشاهده نکنید.
ریاضیات موردنیاز
کتاب برای خوانندهای با پسزمینه پایه Applied Mathematics طراحی شده است. آشنایی با جبر خطی، مشتق، احتمال و مفاهیم مقدماتی بهینهسازی مطالعه را بسیار آسانتر میکند. با این حال، نویسنده تلاش کرده پیشنیازهای ریاضی را تا حد ممکن محدود نگه دارد و مفاهیم را قبل از فرمول با بیان شهودی معرفی کند.
اگر بخشی از ریاضیات برایتان دشوار است، بهتر است همان مفهوم را با مثال عددی و Notebook بررسی کنید. در Deep Learning، ترکیب شهود هندسی، فرمول و اجرای کد معمولاً مؤثرتر از حفظ فرمول به تنهایی است.
تصاویر و نمودارهای آموزشی
یکی از ویژگیهای برجسته کتاب تعداد زیاد تصاویر رنگی و نمودارهای توضیحی است. بسیاری از مفاهیم Machine Learning ماهیت هندسی دارند و تصویر میتواند رابطهای را که در چند خط فرمول پنهان است روشن کند.
نمودارها برای موضوعاتی مانند مرز تصمیم، ساختار شبکه، جریان داده، Attention و مدلهای مولد اهمیت ویژه دارند. این سبک ارائه باعث میشود کتاب برای تدریس دانشگاهی و مطالعه مستقل هر دو مناسب باشد.
این کتاب برای چه کسانی مناسب است؟
- دانشجویان علوم کامپیوتر و هوش مصنوعی که یک کتاب درسی مدرن برای Deep Learning میخواهند.
- برنامهنویسانی که با مدلهای آماده کار کردهاند و میخواهند منطق داخلی آنها را بفهمند.
- علاقهمندان Computer Vision، NLP و Generative AI.
- پژوهشگران تازهواردی که به Transformer و Diffusion Model نیاز دارند.
- مهندسان Machine Learning که میخواهند پایه نظری خود را تقویت کنند.
- افرادی که منبعی بصری با تمرینهای Python میخواهند.
این کتاب برای چه کسانی ممکن است دشوار باشد؟
اگر هنوز هیچ آشنایی با Programming، Linear Algebra یا Calculus ندارید، بعضی فصلها دشوار خواهند بود. کتاب تلاش میکند دسترسپذیر باشد، اما Deep Learning ذاتاً به مفاهیم ریاضی و محاسباتی وابسته است. در این حالت بهتر است همزمان یک منبع مقدماتی Python و ریاضیات Machine Learning را نیز مطالعه کنید.
همچنین کتاب جایگزین Documentation یک Framework نیست. اگر هدف شما فقط یادگیری APIهای PyTorch یا TensorFlow است، به منبع عملی مکمل نیاز دارید. ارزش این اثر بیشتر در فهم مفاهیم، مدلها و منطق ریاضی آنهاست.
چطور کتاب را مطالعه کنیم؟
روش مناسب این است که فصلها را در چند مرحله بخوانید. در مرور اول، روی ایده اصلی و شکلها تمرکز کنید. در مرحله دوم فرمولها را دنبال کنید و تلاش کنید رابطه آنها با نمودارها را بفهمید. سپس Notebook مربوط را اجرا و بخشی از مدل را خودتان پیادهسازی کنید.
برای فصلهای پیشرفته مانند Transformer یا Diffusion، بازگشت به مباحث Optimization، Probability و Loss Function بسیار طبیعی است. یادگیری Deep Learning خطی نیست و مرور دوباره مفاهیم قبلی بخشی از فرایند تسلط محسوب میشود.
چرا Understanding Deep Learning ارزش بررسی دارد؟
بسیاری از کتابهای Deep Learning قبل از موج Transformerها و Diffusion Modelها منتشر شدهاند. آن منابع هنوز برای مبانی ارزشمند هستند، اما برای دیدن معماریهای جدید باید منابع دیگری مطالعه شود. اثر Simon Prince تلاش کرده مبانی کلاسیک و موضوعات جدید را در یک مسیر واحد قرار دهد.
از طرف دیگر، کتاب از پر کردن صفحات با جزئیات فرعی پرهیز میکند و روی ایدههای کلیدی تمرکز دارد. همین انتخاب باعث شده بتواند طیف گستردهای از مباحث را بدون تبدیل شدن به یک مرجع غیرقابلخواندن پوشش دهد.
جمعبندی
Understanding Deep Learning اثر Simon J. D. Prince یک کتاب درسی مدرن برای فهم Deep Learning از مبانی تا معماریهای پیشرفته است. کتاب با Supervised Learning و شبکههای عصبی آغاز میشود، سپس Loss، Optimization، Backpropagation، Regularization و CNN را بررسی میکند و در ادامه به Residual Networks، Attention، Transformers، Graph Neural Networks و مدلهای مولد میرسد.
پوشش Diffusion Models، تصاویر آموزشی فراوان و 68 تمرین Python Notebook از ویژگیهای مهم اثر هستند. اگر به دنبال منبعی هستید که بین توضیح شهودی، ریاضی و تمرین عملی تعادل ایجاد کند و در عین حال موضوعات مدرن Deep Learning را نیز پوشش دهد، این کتاب گزینهای جدی برای مطالعه است. بهترین نتیجه زمانی به دست میآید که متن، فرمولها و Notebookها را در کنار هم دنبال کنید و هر مفهوم را با اجرای کد آزمایش کنید.





نقد و بررسیها
هنوز بررسیای ثبت نشده است.