
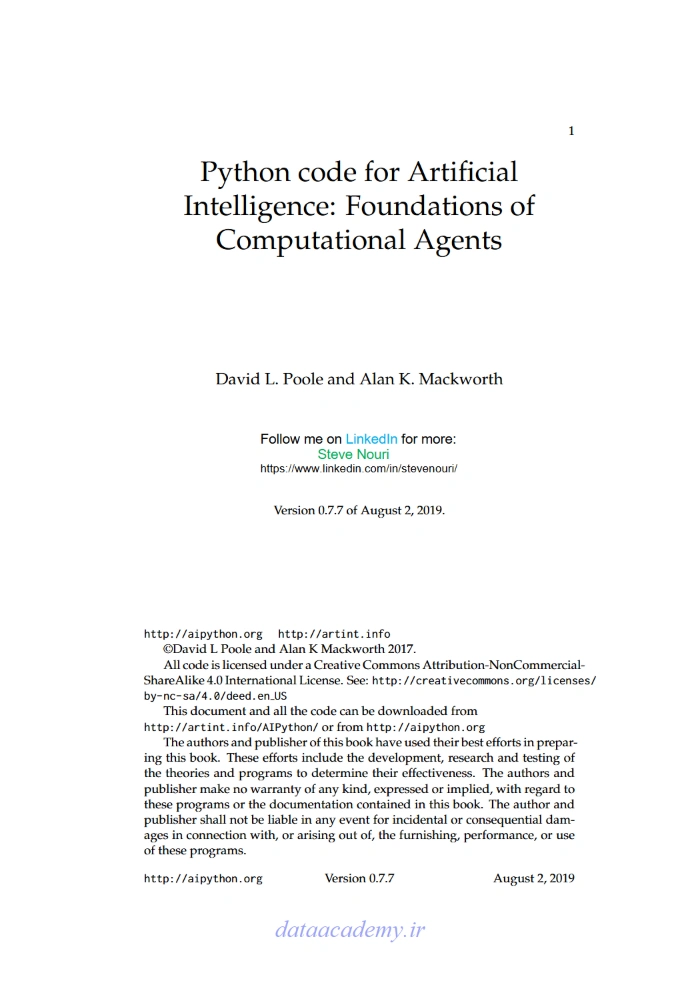


کتاب هوش مصنوعی و پایتون نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 221 صفحه
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی فایل AI + Python
فایل این محصول با نام AI + Python.pdf، زبان انگلیسی و 221 صفحه ثبت شده است. عنوان محصول نیز به هوش مصنوعی و پایتون اشاره دارد. چون در اطلاعات موجود نام نویسنده، ناشر یا ویرایش مشخصی بهصورت قطعی ثبت نشده، این توضیحات از نسبت دادن فایل به فرد یا کتاب خاص خودداری میکند و فقط بر موضوع واقعی آن یعنی ارتباط میان Artificial Intelligence و Python تمرکز دارد.
Python یکی از زبانهای پرکاربرد در آموزش و توسعه سیستمهای هوش مصنوعی است، زیرا Syntax خوانا، اکوسیستم علمی گسترده و ابزارهای متنوعی برای Data Processing، Machine Learning، Computer Vision و Natural Language Processing دارد. با این حال یادگیری AI به معنی حفظ چند Library نیست؛ درک مسئله، داده، Algorithm، Evaluation و محدودیت Model اهمیت بیشتری دارد.
هوش مصنوعی چیست؟
Artificial Intelligence حوزهای است که به طراحی سیستمهایی میپردازد که Taskهایی مانند استدلال، تصمیمگیری، یادگیری، تشخیص Pattern، پردازش زبان یا درک تصویر را انجام میدهند. AI یک Algorithm منفرد نیست و مجموعه بزرگی از روشها را شامل میشود.
Machine Learning، Search، Planning، Knowledge Representation و Neural Networks نمونههایی از مسیرهای اصلی این حوزه هستند.
چرا Python برای AI مناسب است؟
Python کد نسبتاً خوانایی دارد و اجازه میدهد دانشجو بیشتر روی Concept تمرکز کند تا جزئیات پیچیده Syntax. علاوه بر آن، Libraryهایی مانند NumPy، pandas، scikit-learn و ابزارهای Deep Learning محیط مناسبی برای Experiment فراهم میکنند.
مزیت دیگر Python وجود Community بزرگ و مستندات فراوان است، اما انتخاب Library باید متناسب با هدف پروژه باشد.
پیشنیازهای مطالعه
برای شروع، آشنایی با Variable، Condition، Loop، Function، List، Dictionary و Module در Python مفید است. برای فهم عمیقتر AI نیز جبر خطی، Probability و Calculus پایه اهمیت دارند.
لازم نیست همه ریاضیات از ابتدا کامل باشد؛ میتوان مفاهیم را همزمان با نیاز پروژه یاد گرفت.
NumPy و محاسبات عددی
بسیاری از الگوریتمهای AI با Vector و Matrix کار میکنند. NumPy ساختار Array و Operationهای عددی کارآمد فراهم میکند.
فهم Shape، Broadcasting، Indexing و Matrix Operation کمک میکند کد Machine Learning بهتر درک شود.
داده در پروژههای AI
کیفیت داده مستقیماً روی Model اثر دارد. داده ناقص، Label اشتباه، Bias یا Leakage میتواند حتی Algorithm قدرتمند را بیاعتماد کند.
قبل از Training باید Source داده، Meaning Featureها و فرآیند جمعآوری بررسی شود.
Data Cleaning
پاکسازی شامل مدیریت Missing Value، Duplicate، Outlier، Typeهای نادرست و ناسازگاری واحدهاست. تصمیم درباره حذف یا اصلاح داده باید بر اساس Domain باشد.
پاکسازی بیش از حد نیز میتواند Signal واقعی را حذف کند.
Feature Engineering
Feature Representation تعیین میکند Model چه اطلاعاتی را میبیند. در داده جدولی، ساخت Ratio، Aggregate یا Encoding مناسب میتواند Performance را بهبود دهد.
در Deep Learning بخشی از Featureها توسط Network آموخته میشوند، اما کیفیت Input همچنان مهم است.
Supervised Learning
در Supervised Learning هر نمونه دارای Target است. Model رابطه میان Input و Output را از Training Data یاد میگیرد.
Classification و Regression دو نوع مهم این رویکرد هستند.
Classification
Classification برای انتخاب Class استفاده میشود؛ مانند تشخیص نوع پیام، دستهبندی تصویر یا وضعیت یک نمونه. Logistic Regression، Tree، SVM و Neural Network از روشهای قابل استفاده هستند.
Accuracy باید همراه با Precision، Recall و Confusion Matrix بررسی شود، بهخصوص در داده نامتوازن.
Regression
Regression برای Prediction مقدار عددی است. Linear Regression یکی از Baselineهای پایه محسوب میشود.
MAE و RMSE دو Metric رایجاند که حساسیت متفاوتی به Errorهای بزرگ دارند.
Unsupervised Learning
در Unsupervised Learning Label آماده وجود ندارد و Model به دنبال Structure در Data است. Clustering و Dimensionality Reduction نمونههای اصلی هستند.
Result این روشها باید با Context مسئله تفسیر شود.
K-Means
K-Means نمونهها را حول چند Centroid گروهبندی میکند. مقدار k و Scaling Featureها روی نتیجه اثر زیادی دارند.
Cluster ایجادشده الزاماً گروه واقعی در Domain نیست و باید اعتبار آن بررسی شود.
PCA
Principal Component Analysis برای کاهش Dimension و پیدا کردن Directionهای دارای Variance بیشتر استفاده میشود. PCA میتواند Visualization و Compression را آسانتر کند.
قبل از PCA معمولاً Scaling Featureها اهمیت دارد.
Search در هوش مصنوعی
بخش کلاسیک AI شامل Search در فضای State است. مسئله به State اولیه، Action، Transition و Goal تبدیل میشود و Algorithm مسیر مناسب را پیدا میکند.
Breadth-first، Depth-first و روشهای Heuristic نمونههایی از Strategyهای Search هستند.
Heuristic
Heuristic تخمینی از فاصله تا Goal ارائه میدهد و میتواند Search را هدفمندتر کند. کیفیت Heuristic روی تعداد Stateهای بررسیشده اثر مستقیم دارد.
A* Search
A* هزینه طیشده و تخمین هزینه باقیمانده را ترکیب میکند. در شرایط مناسب میتواند مسیر بهینه پیدا کند.
این Algorithm مثال مناسبی برای ارتباط طراحی Heuristic با Performance است.
Knowledge Representation
همه مسائل AI صرفاً Statistical نیستند. در بعضی کاربردها Fact، Rule، Relation و Constraint باید صریح نمایش داده شوند.
Representation مناسب مشخص میکند سیستم چه نوع استدلالی میتواند انجام دهد.
Rule-Based Systems
سیستم Rule-based تصمیم را بر اساس Ruleهای صریح میگیرد. مزیت آن Transparency است، اما نگهداری هزاران Rule پیچیده میشود.
در بسیاری از محصولات، Rule و ML میتوانند مکمل یکدیگر باشند.
Probability در AI
دنیای واقعی پر از عدم قطعیت است. Probability امکان مدلسازی uncertainty را فراهم میکند.
Bayes Rule یکی از ابزارهای مهم برای Update کردن باور بر اساس Evidence جدید است.
Naive Bayes
Naive Bayes یک Classifier احتمالاتی ساده و سریع است. با وجود فرض Independence قوی، در بعضی مسائل متنی عملکرد مناسبی دارد.
Decision Trees
Decision Tree با Ruleهای متوالی Feature Space را تقسیم میکند. ساختار درختی تفسیر Prediction را آسان میکند.
Tree عمیق ممکن است Overfit شود و نیاز به کنترل Complexity دارد.
Random Forest
Random Forest چند Tree متنوع را ترکیب میکند و معمولاً نسبت به یک Tree منفرد Stableتر است. این روش برای دادههای جدولی Baseline قدرتمندی محسوب میشود.
Neural Networks
Neural Network از Layerهای متصل تشکیل شده که Transformationهای متوالی انجام میدهند. Weightها در Training طوری تغییر میکنند که Loss کاهش پیدا کند.
فهم Forward Pass، Loss و Gradient پایه درک Deep Learning است.
Activation Function
Activation Function غیرخطی به Network اجازه میدهد Relation پیچیدهتر از یک Transformation خطی را یاد بگیرد.
ReLU و خانوادههای مشابه در بسیاری از Architectureها استفاده میشوند.
Backpropagation
Backpropagation Gradient Loss را نسبت به Parameterها محاسبه میکند. Optimizer با استفاده از این Gradient Weightها را Update میکند.
Gradient ناپایدار، Learning Rate و Initialization میتوانند Training را تحت تأثیر قرار دهند.
Deep Learning
Deep Learning از Networkهای چندلایه برای یادگیری Representation استفاده میکند. کاربردهای مهم آن در Vision، Speech و Language دیده میشوند.
مدل عمیق به Data و Computation بیشتری نیاز دارد و همیشه انتخاب مناسب برای مسئله کوچک نیست.
Computer Vision
در Computer Vision داده ورودی Image یا Video است. Classification، Detection و Segmentation از Taskهای اصلی هستند.
کیفیت Annotation، Variation نور و Domain Shift در Performance واقعی اهمیت دارند.
Natural Language Processing
NLP به پردازش Text و Language میپردازد. Classification متن، استخراج اطلاعات، Translation و Question Answering نمونههایی از کاربردها هستند.
Representation زبان از روشهای آماری کلاسیک تا Transformerها تکامل پیدا کرده است.
Tokenization
قبل از پردازش Language، Text به Unitهایی مانند Token تبدیل میشود. انتخاب Tokenization روی Vocabulary و Model اثر دارد.
Embeddings
Embedding Token یا Entity را به Vector تبدیل میکند. فاصله در فضای Vector میتواند بخشی از Similarity معنایی را نمایش دهد.
Reinforcement Learning
در Reinforcement Learning Agent با Environment تعامل میکند و از Reward یاد میگیرد. تصمیمهای امروز میتوانند روی Reward آینده اثر بگذارند.
State، Action، Policy و Value از مفاهیم اصلی هستند.
Training و Test
Data باید پیش از Modeling به بخشهای مستقل تقسیم شود. Test Set برای Evaluation نهایی است و نباید برای انتخاب Hyperparameter استفاده شود.
Validation
Validation برای Model Selection و Hyperparameter Tuning استفاده میشود. Cross-validation در Dataset کوچک میتواند تخمین پایدارتری بدهد.
Overfitting
Overfitting یعنی Model Training Data را بیش از الگوی عمومی یاد گرفته است. Training Performance خوب و Test Performance ضعیف نشانه رایج آن است.
Regularization، Data بیشتر و کاهش Complexity از راههای کنترل هستند.
Underfitting
Underfitting زمانی است که Model حتی Training Data را خوب توضیح نمیدهد. Feature ضعیف یا Model بیش از حد ساده میتواند علت باشد.
Bias و Variance
Bias بالا معمولاً به Simplification زیاد و Variance بالا به حساسیت زیاد نسبت به Training Data مربوط است. انتخاب Model مناسب به تعادل میان این دو نیاز دارد.
Hyperparameters
Hyperparameter قبل از Training انتخاب میشود؛ مانند Learning Rate، Depth یا تعداد Neighbor. انتخاب باید بر اساس Validation انجام شود.
Data Leakage
Leakage زمانی رخ میدهد که اطلاعاتی وارد Training شود که در زمان واقعی Prediction در دسترس نیست. این خطا Performance ظاهری را غیرواقعی میکند.
حتی Scaling روی کل Dataset پیش از Split میتواند Leakage ایجاد کند.
Imbalanced Data
اگر یک Class بسیار کم باشد، Accuracy ممکن است گمراهکننده باشد. Precision، Recall، F1، Weighting یا Sampling باید متناسب با مسئله استفاده شوند.
Explainability
در کاربردهای حساس باید بتوان رفتار Model را تحلیل کرد. Feature Importance یا روشهای Explanation میتوانند سرنخ بدهند، اما Explanation آماری الزاماً رابطه علّی نیست.
AI Ethics
Model میتواند Bias موجود در Data را بازتولید یا تشدید کند. Fairness، Privacy، Transparency و Human Oversight باید از ابتدا در طراحی محصول دیده شوند.
Privacy
داده شخصی باید فقط به اندازه نیاز جمعآوری و با Control مناسب نگهداری شود. Training Data ممکن است حاوی Information حساس باشد و نیاز به Governance دارد.
Security
AI System نیز یک Software System است و Input Validation، Access Control، Dependency Management و Logging برای آن اهمیت دارند.
Model نباید بهعنوان جایگزین Controlهای امنیتی پایه استفاده شود.
Reproducibility
Seed، Version Libraryها، Dataset Split، Preprocessing و Hyperparameterها باید ثبت شوند. بدون این اطلاعات مقایسه Experimentها دشوار میشود.
Model Serialization
پس از Training ممکن است Model ذخیره و در Application استفاده شود. File مدل باید مانند Artifact نرمافزاری Version و Validate شود.
Deployment
Deployment فقط قرار دادن Model روی Server نیست. Preprocessing در Production باید دقیقاً با Training هماهنگ باشد.
Latency، Memory، Throughput و Failure Handling نیز باید سنجیده شوند.
Monitoring مدل
Performance مدل میتواند با تغییر Distribution داده افت کند. Data Drift و Prediction Distribution باید Monitor شوند.
در صورت وجود Label با تأخیر، Metric واقعی نیز باید دورهای محاسبه شود.
Baseline
قبل از Model پیچیده Baseline ساده بسازید. اگر Neural Network از Logistic Regression بهتر نیست، Complexity اضافی توجیه ندارد.
انتخاب پروژه تمرینی
برای شروع، یک Dataset کوچک Classification انتخاب کنید. Data را پاکسازی کنید، Baseline بسازید، دو یا سه Model را با Metric یکسان مقایسه و Failureها را تحلیل کنید.
بعد میتوانید پروژهای در NLP یا Vision اضافه کنید تا تفاوت Data Typeها را ببینید.
روش مطالعه پیشنهادی
هر Concept را با Python اجرا کنید. ابتدا نسخه ساده را بفهمید و سپس Library حرفهای استفاده کنید. کپی کردن Notebook بدون تحلیل رفتار Model یادگیری عمیقی ایجاد نمیکند.
برای هر Experiment سؤالهای ثابتی بنویسید: Data چیست؟ Target چیست؟ Baseline چیست؟ Metric چیست؟ Failure کجاست؟
این فایل برای چه کسانی مناسب است؟
- افرادی که Python مقدماتی میدانند و وارد AI میشوند.
- دانشجویان علوم کامپیوتر، داده و مهندسی.
- برنامهنویسان علاقهمند به Machine Learning.
- افرادی که میخواهند ارتباط میان الگوریتمهای AI و Python را درک کنند.
- دانشجویانی که به یک مسیر عملی برای شروع پروژههای AI نیاز دارند.
جمعبندی
فایل AI + Python موضوعی مناسب برای ساختن پلی میان برنامهنویسی Python و مفاهیم هوش مصنوعی است. Data Processing، Search، Probability، Machine Learning، Neural Network، NLP، Computer Vision و Reinforcement Learning هر کدام بخشی از منظره بزرگ AI هستند.
بهترین استفاده از چنین منبعی زمانی است که مطالعه با Experiment واقعی همراه شود. Python ابزار اجرای ایدههاست، اما کیفیت سیستم AI به تعریف درست مسئله، Data، Evaluation، Security و Monitoring وابسته است. اگر خواننده این دید را حفظ کند، از مرحله اجرای کد آماده عبور میکند و به فهم مهندسی و تحلیلی هوش مصنوعی نزدیک میشود.





نقد و بررسیها
هنوز بررسیای ثبت نشده است.