
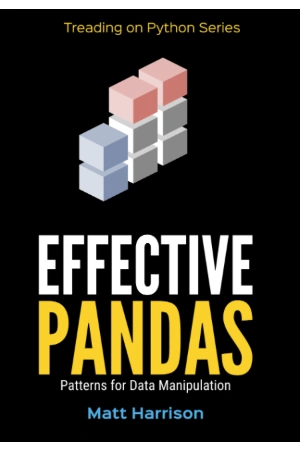

کتاب Effective Pandas (کاربرد مؤثر Pandas) نسخه انگلیسی PDF
قیمت اصلی ۸۹.۰۰۰ تومان بود.۴۵.۰۰۰ تومانقیمت فعلی ۴۵.۰۰۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 20 صفحه
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
خرید و دانلود کتاب Effective Pandas نسخه انگلیسی PDF
کتاب Effective Pandas راهنمایی کاربردی برای استفاده حرفهایتر از کتابخانه Pandas در زبان برنامهنویسی پایتون است. این کتاب به خواننده کمک میکند از نوشتن کدهای پراکنده و کند فاصله بگیرد و تحلیل دادههای جدولی را با ساختاری خواناتر، سریعتر و قابل نگهداریتر انجام دهد.
Pandas یکی از مهمترین ابزارهای اکوسیستم علم داده پایتون است و برای پاکسازی، تبدیل، ترکیب، خلاصهسازی و تحلیل دادهها استفاده میشود. با این حال، آشنایی با چند دستور پایه برای استفاده مؤثر از آن کافی نیست. انتخاب نوع داده مناسب، درک رفتار ایندکس، استفاده از عملیات برداری و طراحی زنجیرههای پردازشی منظم میتواند کیفیت کد را به شکل محسوسی بهبود دهد.
معرفی کتاب Effective Pandas
بسیاری از کاربران Pandas کار خود را با خواندن فایل CSV، انتخاب چند ستون و اجرای چند فیلتر آغاز میکنند. با بزرگتر شدن پروژه، کد ممکن است شامل متغیرهای موقت متعدد، حلقههای غیرضروری، تغییرات درجا و عملیات تکراری شود. این الگوها درک برنامه را دشوار میکنند و احتمال خطا را افزایش میدهند.
کتاب کاربرد مؤثر Pandas بر الگوها و عادتهایی تمرکز دارد که به نوشتن کد دادهمحور بهتر کمک میکنند. خواننده میآموزد چگونه از قابلیتهای داخلی Series و DataFrame استفاده کند، تبدیلها را بهصورت شفاف سازمان دهد و از راهکارهایی بهره بگیرد که با ساختار واقعی Pandas هماهنگ هستند.
رویکرد کتاب تنها معرفی توابع نیست؛ بلکه نشان میدهد چرا بعضی روشها خواناتر، سریعتر یا ایمنتر هستند و چگونه میتوان یک فرایند تحلیل داده را به مراحل قابل آزمایش و قابل تکرار تقسیم کرد.
Pandas چیست و چرا اهمیت دارد؟
Pandas کتابخانهای برای کار با دادههای ساختاریافته و جدولی در پایتون است. دو ساختار اصلی آن Series و DataFrame هستند. Series معمولاً یک ستون برچسبدار و DataFrame جدولی شامل چند ستون با نوعهای داده متفاوت را نمایش میدهد.
این کتابخانه امکان خواندن داده از فایلها و پایگاههای داده، انتخاب و فیلتر کردن ردیفها، مدیریت مقادیر گمشده، ترکیب جدولها، گروهبندی، محاسبه شاخصهای آماری و کار با دادههای زمانی را فراهم میکند.
اهمیت Pandas در این است که بسیاری از مراحل آمادهسازی داده پیش از مصورسازی، گزارشگیری یا ساخت مدل یادگیری ماشین با آن انجام میشوند. استفاده نادرست از این ابزار میتواند به مصرف حافظه زیاد، نتایج مبهم یا کد دشوار برای نگهداری منجر شود.
در کتاب Effective Pandas چه میآموزید؟
آشنایی عمیقتر با Series
Series یکی از اجزای بنیادی Pandas است. کتاب نشان میدهد چگونه دادهها، ایندکس و نوع داده در یک Series با یکدیگر ارتباط دارند و چرا بسیاری از عملیات بهتر است ابتدا در سطح یک ستون درک شوند.
خواننده با انتخاب مقادیر، اعمال محاسبات، مدیریت دادههای گمشده و استفاده از متدهای زنجیرهای روی Series آشنا میشود.
ساخت و مدیریت DataFrame
DataFrame ساختاری دوبعدی برای نگهداری دادههای جدولی است. کتاب روشهای ساخت DataFrame از فایل، دیکشنری، آرایه و منابع دیگر را بررسی میکند و بر اهمیت نامگذاری مناسب ستونها و شناخت ساختار جدول تأکید دارد.
درک تفاوت میان مشاهده داده، انتخاب ستون، ایجاد ستون جدید و بازگرداندن یک DataFrame تازه، برای جلوگیری از تغییرات ناخواسته ضروری است.
انتخاب نوع داده مناسب
نوع داده هر ستون بر مصرف حافظه، سرعت پردازش و رفتار عملیات اثر میگذارد. نگهداری مقادیر عددی یا تاریخی در قالب متن میتواند محاسبات را دشوار و کند کند.
کتاب به خواننده کمک میکند نوعهای عددی، متنی، بولی، دستهای و زمانی را بهتر بشناسد و دادهها را در زمان مناسب به نوع صحیح تبدیل کند.
بهینهسازی حافظه با دادههای دستهای
ستونهایی که تعداد محدودی مقدار تکرارشونده دارند، ممکن است برای نوع دستهای مناسب باشند. استفاده درست از این نوع داده میتواند مصرف حافظه را کاهش دهد و بعضی عملیات را سریعتر کند.
البته انتخاب نوع دستهای باید بر اساس ماهیت داده انجام شود و برای تمام ستونهای متنی مناسب نیست.
درک ایندکس و برچسبها
ایندکس در Pandas تنها شماره ردیف نیست و میتواند در همترازی دادهها، انتخاب رکوردها و ترکیب جدولها نقش داشته باشد. کتاب تفاوت میان ایندکس برچسبی و موقعیت عددی را روشن میکند.
شناخت رفتار همترازی خودکار از خطاهایی جلوگیری میکند که هنگام انجام محاسبات میان دو Series با ایندکسهای متفاوت رخ میدهند.
انتخاب داده با loc و iloc
برای انتخاب ردیفها و ستونها میتوان از روشهای مختلفی استفاده کرد. loc بر اساس برچسب و iloc بر اساس موقعیت عددی عمل میکند.
کتاب بر نوشتن انتخابهای صریح و قابل فهم تأکید دارد تا مشخص باشد کد بر چه مبنایی بخشی از داده را استخراج میکند.
فیلتر کردن دادهها
فیلترهای بولی امکان انتخاب ردیفهایی را فراهم میکنند که شرایط مشخصی دارند. ترکیب چند شرط، مدیریت مقادیر گمشده و استفاده صحیح از عملگرها از موضوعات مهم این بخش هستند.
خواننده میآموزد چگونه شرطهای پیچیده را به عبارتهای خوانا تبدیل کند و از محاسبات تکراری جلوگیری نماید.
پاکسازی نام ستونها
نامهای نامنظم، فاصلههای اضافی و ترکیب حروف بزرگ و کوچک میتوانند نوشتن کد را دشوار کنند. استانداردسازی نام ستونها در ابتدای فرایند تحلیل، مراحل بعدی را سادهتر میسازد.
کتاب الگوهایی برای تغییر نام ستونها و ایجاد قرارداد نامگذاری قابل پیشبینی ارائه میدهد.
مدیریت مقادیر گمشده
دادههای واقعی اغلب شامل مقادیر ناقص هستند. حذف تمام ردیفهای ناقص همیشه راهحل مناسبی نیست و ممکن است اطلاعات ارزشمند را از بین ببرد.
کتاب روشهای شناسایی، شمارش، حذف یا جایگزینی مقادیر گمشده را بررسی میکند و بر انتخاب راهکار متناسب با معنی داده تأکید دارد.
کار با دادههای متنی
Pandas ابزارهایی برای پاکسازی، جستوجو، جایگزینی، تقسیم و استخراج الگو از رشتهها ارائه میدهد. این عملیات میتوانند بدون نوشتن حلقههای طولانی روی یک ستون کامل اجرا شوند.
خواننده با استفاده از متدهای متنی برای استانداردسازی نامها، کدها و مقادیر دستهای آشنا میشود.
کار با تاریخ و زمان
دادههای زمانی برای تحلیل روند، گزارش دورهای و ساخت ویژگیهای زمانی اهمیت دارند. کتاب نحوه تبدیل متن به تاریخ، استخراج اجزای زمان و فیلتر کردن بازهها را توضیح میدهد.
شناخت نوع datetime به انجام محاسبات زمانی دقیقتر و جلوگیری از مقایسههای نادرست کمک میکند.
ایجاد و تبدیل ستونها
در بسیاری از پروژهها لازم است ستونهای جدید بر اساس دادههای موجود ساخته شوند. کتاب روشهایی را بررسی میکند که تبدیلها را شفاف و قابل پیگیری نگه میدارند.
استفاده از عملیات برداری و متدهای مناسب معمولاً از حلقه و پردازش ردیفبهردیف سریعتر و خواناتر است.
عملیات برداری
عملیات برداری به اجرای یک محاسبه روی مجموعهای از مقادیر بدون نوشتن حلقه صریح پایتون اشاره دارد. Pandas و NumPy برای چنین پردازشی بهینه شدهاند.
کتاب نشان میدهد چگونه جایگزین کردن حلقهها و apply غیرضروری با عملیات داخلی میتواند کارایی را بهبود دهد.
استفاده آگاهانه از apply
متد apply انعطافپذیر است اما همیشه بهترین انتخاب نیست. بسیاری از محاسبات با متدهای برداری، متدهای رشتهای یا عملیات گروهبندی سریعتر اجرا میشوند.
خواننده میآموزد چه زمانی apply مفید است و چه زمانی باید به دنبال راهکار داخلی و تخصصیتر باشد.
زنجیرهسازی متدها
Method Chaining یا زنجیرهسازی متدها روشی برای نمایش مراحل تبدیل داده در یک جریان پیوسته است. این سبک میتواند وابستگی به متغیرهای موقت را کاهش دهد و مسیر داده را روشنتر کند.
کتاب بر ساخت زنجیرههای خوانا، شکستن مراحل پیچیده و استفاده از توابع کوچک برای تبدیلهای قابل استفاده مجدد تأکید دارد.
طراحی خط لوله پاکسازی داده
بهجای ویرایش پراکنده یک DataFrame، میتوان مراحل پاکسازی را به شکل خط لوله تعریف کرد. هر مرحله ورودی را دریافت میکند و خروجی مشخصی تحویل میدهد.
این رویکرد آزمایش، بازبینی و اجرای دوباره تحلیل را آسانتر میکند و برای پروژههای تیمی ارزش زیادی دارد.
گروهبندی و تجمیع دادهها
عملیات groupby برای تقسیم داده به گروهها و محاسبه شاخصهایی مانند مجموع، میانگین، تعداد یا مقدار بیشینه استفاده میشود.
کتاب منطق تقسیم، اعمال و ترکیب را توضیح میدهد و روش ساخت خروجیهای خلاصه و قابل استفاده برای گزارش را بررسی میکند.
تفاوت aggregate، transform و filter
هرکدام از این عملیات هدف متفاوتی دارند. aggregate معمولاً خروجی خلاصه تولید میکند، transform نتیجهای هماندازه داده اصلی بازمیگرداند و filter گروهها را بر اساس شرط نگه میدارد یا حذف میکند.
شناخت این تفاوت به انتخاب متد مناسب و جلوگیری از کدهای پیچیده کمک میکند.
ترکیب و اتصال DataFrameها
اطلاعات یک پروژه ممکن است در چند جدول جداگانه ذخیره شده باشند. merge، join و concat ابزارهای اصلی ترکیب این دادهها هستند.
کتاب به اهمیت کلید اتصال، نوع رابطه و بررسی تعداد ردیفها پیش و پس از ترکیب توجه دارد تا از تکثیر یا حذف ناخواسته داده جلوگیری شود.
تغییر شکل دادهها
بعضی تحلیلها به داده عریض و بعضی به داده طولی نیاز دارند. عملیاتهایی مانند pivot، pivot_table، stack، unstack و melt برای تغییر شکل جدول استفاده میشوند.
خواننده میآموزد چگونه ساختار داده را متناسب با تحلیل، نمودار یا گزارش موردنظر تنظیم کند.
مرتبسازی و رتبهبندی
مرتبسازی بر اساس یک یا چند ستون و محاسبه رتبه برای تحلیل مقایسهای کاربرد دارد. کتاب روش مدیریت مقادیر مساوی و ترتیب صعودی یا نزولی را بررسی میکند.
حذف دادههای تکراری
رکوردهای تکراری میتوانند آمار و گزارشها را مخدوش کنند. تشخیص تکرار باید بر اساس ستونهایی انجام شود که هویت واقعی رکورد را مشخص میکنند.
کتاب به جای حذف بیبررسی، بر شناخت علت ایجاد تکرار و ثبت قواعد پاکسازی تأکید دارد.
نمونهگیری و بررسی داده
مشاهده چند ردیف اول همیشه تصویر کاملی از مجموعهداده ارائه نمیدهد. نمونهگیری تصادفی، بررسی مقادیر منحصربهفرد و محاسبه آمار توصیفی میتواند مشکلات پنهان را آشکار کند.
این روشها در مرحله تحلیل اکتشافی برای شناخت توزیع و کیفیت اطلاعات کاربرد دارند.
بهبود کارایی کد Pandas
عملکرد ضعیف ممکن است از نوع داده نامناسب، کپیهای غیرضروری، حلقههای پایتون یا محاسبات تکراری ناشی شود. کتاب راهکارهایی برای تشخیص این الگوها ارائه میدهد.
اندازهگیری زمان و مصرف حافظه پیش از بهینهسازی اهمیت دارد؛ زیرا تغییر کد بدون معیار مشخص ممکن است پیچیدگی را افزایش دهد بدون آنکه سود واقعی ایجاد کند.
الگوهای مؤثر در کار با Pandas
استفاده از نوع داده صحیح: تبدیل ستونها به نوع عددی، زمانی یا دستهای متناسب با محتوای واقعی.
ترجیح عملیات برداری: استفاده از قابلیتهای داخلی بهجای حلقههای ردیفبهردیف.
زنجیرهسازی خوانا: نمایش مراحل تبدیل در یک جریان مشخص و قابل پیگیری.
پرهیز از تغییرات مبهم درجا: بازگرداندن خروجی روشن و کاهش اثرات جانبی.
اعتبارسنجی پس از اتصال جدولها: بررسی تعداد ردیفها، کلیدها و مقادیر گمشده.
تقسیم منطق به توابع کوچک: ساخت تبدیلهای قابل آزمایش و قابل استفاده مجدد.
ثبت فرضیات داده: مشخص کردن معنی ستونها، واحدها و قواعد پاکسازی.
خطاهای رایج کاربران Pandas
استفاده بیش از حد از حلقهها
حلقه زدن روی ردیفهای DataFrame معمولاً کندتر از عملیات برداری است. ابتدا باید بررسی شود که آیا یک متد داخلی میتواند همان نتیجه را تولید کند.
نادیده گرفتن نوع داده
ستون object ممکن است ترکیبی از متن، عدد و مقدار گمشده باشد. ادامه تحلیل بدون اصلاح نوع داده میتواند به خطا یا نتیجه نادرست منجر شود.
اتصال جدولها بدون بررسی کلید
وجود کلید تکراری در هر دو جدول ممکن است تعداد ردیفها را چند برابر کند. پیش از merge باید یکتایی و کیفیت کلیدها بررسی شوند.
تغییر زنجیرهای و خروجیهای مبهم
انتخاب بخشی از DataFrame و سپس تغییر آن ممکن است رفتار نامشخصی ایجاد کند. استفاده صریح از loc و ساخت خروجی مشخص، کد را قابل اعتمادتر میسازد.
استفاده بیدلیل از apply
apply برای توابع سفارشی مفید است اما استفاده از آن برای عملیات ساده میتواند سرعت را کاهش دهد. متدهای تخصصی معمولاً انتخاب بهتری هستند.
ساخت متغیرهای موقت فراوان
تعداد زیاد DataFrameهای میانی مسیر تحلیل را دشوار میکند. زنجیرهسازی متعادل و توابع نامگذاریشده میتوانند جریان پردازش را روشنتر کنند.
حذف بیبررسی مقادیر گمشده
حذف تمام ردیفهای ناقص ممکن است سوگیری ایجاد کند. تصمیم باید بر اساس علت نبود داده و نیاز تحلیل گرفته شود.
کتاب Effective Pandas برای چه کسانی مناسب است؟
تحلیلگران داده
افرادی که بهطور روزمره فایلهای جدولی را پاکسازی و تحلیل میکنند، میتوانند با الگوهای کتاب سرعت و خوانایی گردش کار خود را افزایش دهند.
دانشمندان داده
دانشمندان داده برای آمادهسازی ویژگیها و ساخت مجموعهداده آموزشی به Pandas وابسته هستند. شناخت عمیقتر این ابزار میتواند زمان آمادهسازی و احتمال خطا را کاهش دهد.
برنامهنویسان پایتون
توسعهدهندگانی که دادههای CSV، Excel، JSON یا خروجی پایگاه داده را پردازش میکنند، با مطالعه این کتاب روشهای منظمتری برای مدیریت داده میآموزند.
دانشجویان و پژوهشگران
دانشجویانی که برای پروژه، پایاننامه یا تحلیل آزمایشها از پایتون استفاده میکنند، میتوانند کدهای قابل تکرارتر و قابل دفاعتری بنویسند.
کاربران آشنا با مبانی Pandas
این کتاب بهویژه برای افرادی مفید است که دستورات پایه را میدانند اما میخواهند از سطح اجرای مثالهای ساده به طراحی فرایندهای حرفهایتر برسند.
پیشنیازهای مطالعه کتاب
آشنایی مقدماتی با زبان پایتون، متغیرها، توابع و ساختارهای داده برای استفاده بهتر از مطالب کتاب مفید است. شناخت اولیه Series و DataFrame نیز باعث میشود تمرکز بیشتری بر الگوهای حرفهای داشته باشید.
برای بسیاری از مباحث نیاز به دانش ریاضی پیشرفته نیست؛ اما آشنایی با مفاهیم پایه آمار و دادههای جدولی میتواند درک مثالها را آسانتر کند.
مزایای یادگیری حرفهای Pandas
استفاده مؤثر از Pandas باعث میشود پاکسازی و تحلیل داده با کد کمتر و ساختار روشنتر انجام شود. این موضوع علاوه بر سرعت توسعه، بازبینی و همکاری تیمی را نیز بهبود میدهد.
کدهای قابل تکرار امکان اجرای مجدد تحلیل روی دادههای جدید را فراهم میکنند. در نتیجه، فرایندهای دستی و خطاهای ناشی از کپی و جایگذاری کاهش مییابند.
مهارت در Pandas همچنین پایه مناسبی برای ورود به مصورسازی داده، یادگیری ماشین، مهندسی داده و ساخت گزارشهای خودکار ایجاد میکند.
نسخه انگلیسی کتاب Effective Pandas با فرمت PDF
محصول حاضر شامل نسخه انگلیسی کتاب Effective Pandas با فرمت PDF است. فایل PDF را میتوان در رایانه، لپتاپ، تبلت و تلفن همراه مطالعه کرد و برای مراجعه سریع به موضوعات مختلف مورد استفاده قرار داد.
مطالعه نسخه انگلیسی به کاربران کمک میکند اصطلاحات اصلی Pandas و تحلیل داده را به زبان تخصصی بیاموزند و هنگام مراجعه به مستندات رسمی و منابع برنامهنویسی درک بهتری داشته باشند.
جمعبندی معرفی کتاب Effective Pandas
کتاب Effective Pandas نسخه انگلیسی PDF منبعی کاربردی برای افرادی است که میخواهند کدهای تحلیل داده خود را با Pandas خواناتر، سریعتر و قابل نگهداریتر کنند. این کتاب موضوعاتی مانند Series، DataFrame، نوع داده، ایندکس، پاکسازی، فیلتر، گروهبندی، ترکیب جدولها، تغییر شکل داده، زنجیرهسازی متدها و بهینهسازی عملکرد را پوشش میدهد.
اگر با پایتون و Pandas کار میکنید و میخواهید از روشهای ابتدایی به الگوهای حرفهایتر تحلیل داده برسید، دانلود کتاب Effective Pandas میتواند به توسعه مهارت عملی و کیفیت پروژههای شما کمک کند.






نقد و بررسیها
هنوز بررسیای ثبت نشده است.