
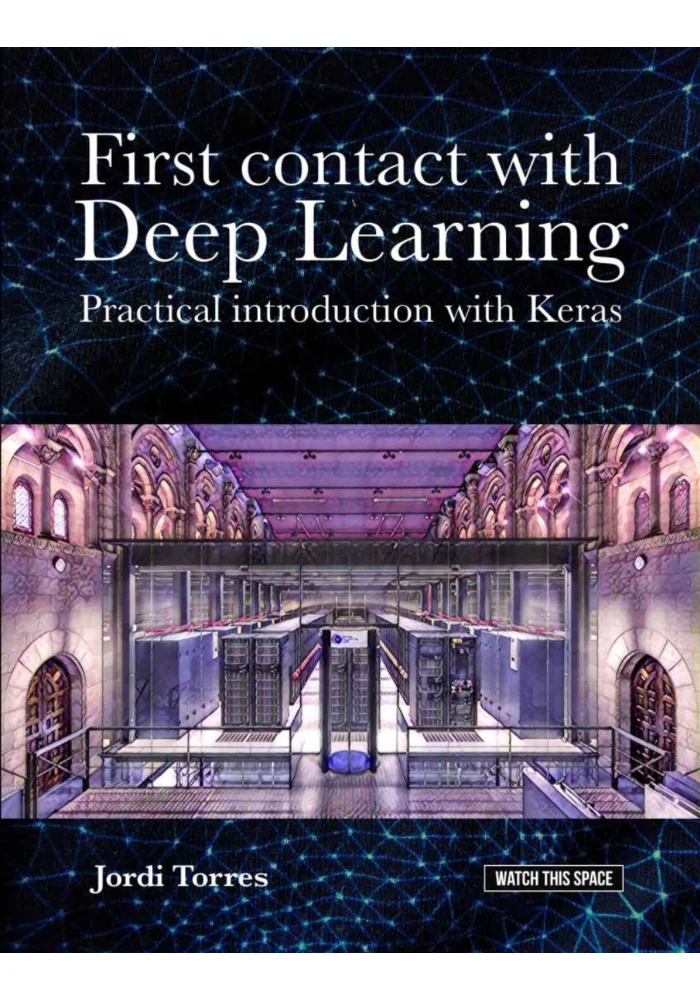


کتاب آشنایی با یادگیری عمیق نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 206 صفحه
- حجم فایل: 6.95 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب First Contact with Deep Learning
First Contact with Deep Learning یک منبع مقدماتی برای ورود ساختاریافته به یادگیری عمیق است. فایل این محصول به زبان انگلیسی و 206 صفحه ثبت شده است. موضوع کتاب بر درک شبکههای عصبی، نحوه آموزش مدل، توابع فعالسازی، Backpropagation، Optimization و معماریهای پایه Deep Learning تمرکز دارد و برای خوانندهای مناسب است که میخواهد قبل از ورود به مدلهای پیچیدهتر، مبانی این حوزه را بفهمد.
یادگیری عمیق بخشی از Machine Learning است که از شبکههای عصبی چندلایه برای ساخت Representationهای پیچیده از داده استفاده میکند. مزیت این رویکرد آن است که مدل میتواند بخشی از Feature Extraction را مستقیماً از داده یاد بگیرد. با این حال Training موفق به Dataset مناسب، معماری، Loss Function، Optimization و Evaluation صحیح وابسته است.
Neuron و شبکه عصبی
یک Neuron ورودیها را با Weightهای مختلف ترکیب میکند، Bias را اضافه میکند و نتیجه را از Activation Function عبور میدهد. با قرار گرفتن تعداد زیادی Neuron در چند Layer، شبکه میتواند Functionهای پیچیده را تقریب بزند.
Weight و Bias پارامترهای قابل یادگیری هستند و در طول Training تغییر میکنند.
لایه ورودی، مخفی و خروجی
Input Layer داده را دریافت میکند، Hidden Layerها Representationهای میانی میسازند و Output Layer نتیجه نهایی را تولید میکند. نوع Output به مسئله بستگی دارد؛ Classification و Regression معماری خروجی متفاوتی دارند.
Activation Function
Activation Function باعث ایجاد Nonlinearity میشود. بدون آن، ترکیب چند لایه خطی در نهایت همچنان یک Transformation خطی خواهد بود.
Sigmoid، Tanh و ReLU از Activationهای شناختهشدهاند. ReLU در بسیاری از شبکههای عمیق به دلیل سادگی و رفتار Gradient مناسب رایج است.
Forward Propagation
در Forward Pass داده از لایههای شبکه عبور میکند تا Prediction ساخته شود. هر Layer خروجی Layer قبلی را به Representation جدید تبدیل میکند.
این مرحله فقط Prediction تولید میکند؛ برای یادگیری باید خطا محاسبه و Gradient به عقب منتقل شود.
Loss Function
Loss Function اختلاف Prediction و Target را به عدد تبدیل میکند. برای Classification معمولاً Cross-Entropy و برای Regression انواع خطای عددی استفاده میشوند.
انتخاب Loss باید با نوع Output و هدف واقعی مسئله هماهنگ باشد.
Backpropagation
Backpropagation با استفاده از Chain Rule مشتق Loss نسبت به Weightهای شبکه را محاسبه میکند. این Gradient نشان میدهد هر Parameter در چه جهتی باید تغییر کند.
فهم Backpropagation کمک میکند Training شبکه به جای یک فرایند جادویی، مجموعهای از محاسبات قابل تحلیل دیده شود.
Gradient Descent
Gradient Descent Parameterها را در جهتی تغییر میدهد که Loss کاهش پیدا کند. Learning Rate تعیین میکند اندازه هر Step چقدر باشد.
Learning Rate بسیار بالا میتواند Training را ناپایدار و مقدار بسیار پایین آن را بسیار کند کند.
Mini-batch Training
در Dataset بزرگ معمولاً همه نمونهها همزمان برای یک Update استفاده نمیشوند. Mini-batch بخشی از داده را انتخاب میکند و Gradient بر اساس همان بخش محاسبه میشود.
Batch Size روی Memory، سرعت و Noise Gradient اثر دارد.
Epoch
یک Epoch زمانی کامل میشود که مدل تمام Training Dataset را یک بار مشاهده کند. تعداد Epoch بیشتر الزاماً بهتر نیست؛ پس از نقطهای مدل ممکن است Overfit کند.
Overfitting
Overfitting زمانی رخ میدهد که شبکه Training Data را بسیار خوب یاد بگیرد اما روی داده جدید عملکرد ضعیفی داشته باشد. تفاوت زیاد Training و Validation یکی از نشانههاست.
Dropout، Regularization، Data Augmentation و Early Stopping برای کنترل این مشکل استفاده میشوند.
Dropout
Dropout در Training بخشی از Neuronها را موقتاً غیرفعال میکند و وابستگی شبکه به مسیرهای خاص را کاهش میدهد.
این روش میتواند Generalization را بهبود دهد، اما نرخ Dropout باید متناسب با معماری تنظیم شود.
Weight Initialization
شروع Weightها با Scale مناسب برای حفظ جریان Signal و Gradient مهم است. Initialization نامناسب میتواند Training را کند یا متوقف کند.
Vanishing Gradient
در شبکه عمیق Gradient ممکن است هنگام حرکت به Layerهای ابتدایی بسیار کوچک شود. در نتیجه این Layerها بهسختی یاد میگیرند.
Activation مناسب، Initialization بهتر و معماریهای جدیدتر برای کاهش این مشکل توسعه یافتهاند.
Convolutional Neural Networks
CNNها برای داده تصویری بسیار مهماند. Convolution با Filterهای محلی Patternهایی مانند Edge و Texture را استخراج میکند و Layerهای عمیقتر Featureهای پیچیدهتر را میسازند.
Weight Sharing باعث میشود تعداد Parameterها نسبت به Fully Connected Network روی Image کمتر باشد.
Pooling
Pooling ابعاد Feature Map را کاهش میدهد و میتواند مقاومت مدل نسبت به جابهجاییهای کوچک را افزایش دهد. Max Pooling یکی از روشهای کلاسیک است.
Recurrent Neural Networks
RNN برای Sequenceهایی مانند متن و Time Series طراحی شده است. Hidden State اطلاعات Stepهای قبلی را به Step بعدی منتقل میکند.
RNN ساده در وابستگیهای طولانی با Vanishing Gradient مشکل دارد و معماریهایی مانند LSTM برای مدیریت بهتر حافظه توسعه یافتهاند.
LSTM
LSTM از Cell State و Gateها برای کنترل جریان اطلاعات استفاده میکند. این معماری در Sequence Prediction، NLP و Time Series کاربرد گستردهای داشته است.
Training و Validation
Training Loss به تنهایی معیار کافی نیست. Validation Data باید جدا باشد تا Generalization بررسی شود.
Hyperparameterها روی Validation تنظیم میشوند و Test Data بهتر است برای ارزیابی نهایی نگه داشته شود.
Normalization
Scale مناسب ورودی میتواند Optimization را سادهتر کند. در شبکهها روشهای مختلف Normalization برای ورودی و Activationها استفاده میشوند.
Data Quality
Deep Learning جایگزین داده خوب نیست. Label اشتباه، Bias Dataset و نمونه ناکافی میتوانند حتی معماری قدرتمند را گمراه کنند.
Error Analysis روی نمونههای اشتباه یکی از مهمترین مراحل بهبود مدل است.
GPU و محاسبات ماتریسی
شبکههای عصبی به عملیات Matrix بزرگ وابستهاند و GPU برای اجرای موازی این محاسبات مناسب است. با این حال مدل کوچک الزاماً به Hardware بسیار قدرتمند نیاز ندارد.
تفاوت Deep Learning با Machine Learning کلاسیک
در روشهای کلاسیک Feature Engineering دستی معمولاً نقش بیشتری دارد. Deep Learning میتواند Representation را از داده یاد بگیرد، اما به داده و محاسبات بیشتری نیاز دارد.
برای Dataset کوچک، مدل کلاسیک گاهی سادهتر و بهتر است.
محدودیت تاریخی کتاب
حوزه Deep Learning سریع تغییر کرده است. Transformerها، مدلهای بزرگ و Frameworkهای جدید ممکن است در این فایل پوشش داده نشده باشند یا فقط اشاره محدودی داشته باشند.
با این حال مفاهیمی مانند Backpropagation، Loss، Optimization، Overfitting و Representation Learning همچنان پایه همه مدلهای جدید هستند.
این کتاب برای چه کسانی مناسب است؟
- دانشجویان تازهوارد به Deep Learning.
- برنامهنویسانی که مبانی شبکه عصبی را میخواهند.
- افرادی که قبل از Frameworkهای پیچیده به دنبال درک مفهومی هستند.
- علاقهمندان Computer Vision و Sequence Modeling.
- کسانی که میخواهند مسیر ورود از Machine Learning به Deep Learning را طی کنند.
جمعبندی
First Contact with Deep Learning یک نقطه شروع برای فهم شبکههای عصبی و اصول Training است. Neuron، Activation، Backpropagation، Gradient Descent، Regularization، CNN و RNN از موضوعات اصلی آن هستند.
اگر هدف شما ساخت پایهای است که بعداً بتوانید با TensorFlow، PyTorch یا مدلهای مدرن کار کنید، فهم همین مفاهیم بنیادی اهمیت بیشتری از حفظ Syntax یک Framework دارد. این کتاب برای شکل دادن چنین پایهای مناسب است.



نقد و بررسیها
هنوز بررسیای ثبت نشده است.