
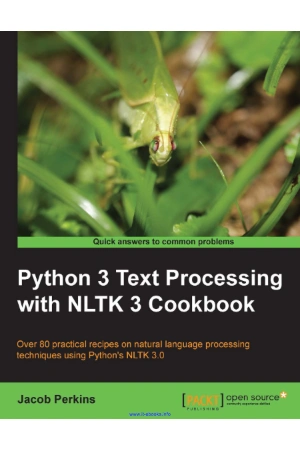

کتاب پردازش متن با پایتون ۳ اثر جیکوب پرکینز نسخه PDF انگلیسی
قیمت اصلی ۸۴.۸۷۰ تومان بود.۳۸.۴۵۰ تومانقیمت فعلی ۳۸.۴۵۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 304 صفحه
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
معرفی کتاب پردازش متن با Python 3 اثر Jacob Perkins
Python 3 Text Processing اثر Jacob Perkins یک منبع عملی برای پردازش متن و آشنایی با ابزارهای Natural Language Processing در Python است. فایل موجود در این محصول با نام Jacob_Perkins_Python_3_Text_Processing.pdf ثبت شده، زبان آن انگلیسی است و 304 صفحه برای آن شناسایی شده است. محور اصلی کتاب کار با متن واقعی، پاکسازی و نرمالسازی داده، Tokenization، تحلیل واژگان، برچسبگذاری دستوری، استخراج ساختار و ساخت Pipelineهای پردازش زبان است.
پردازش متن یکی از حوزههایی است که ظاهر ساده آن میتواند گمراهکننده باشد. یک جمله برای انسان بهراحتی قابل فهم است، اما برای برنامه مجموعهای از کاراکترهاست. سیستم باید مشخص کند مرز کلمه کجاست، شکلهای مختلف یک واژه چه رابطهای دارند، علامتگذاری چه معنایی دارد و چگونه میتوان متن را به ساختاری تبدیل کرد که الگوریتم روی آن کار کند. کتاب Perkins روی همین تبدیل مرحلهای متن خام به داده قابل تحلیل تمرکز میکند.
پردازش متن چیست؟
Text Processing مجموعهای از عملیات برای آمادهسازی، تبدیل و تحلیل متن است. بعضی مراحل بسیار پایهاند، مانند تبدیل Encoding یا حذف فاصلههای اضافی؛ بعضی دیگر به زبانشناسی نزدیکتر هستند، مانند Part-of-Speech Tagging، Chunking یا Named Entity Recognition.
هدف نهایی بسته به پروژه متفاوت است. ممکن است بخواهیم سندها را جستوجو کنیم، متن را دستهبندی کنیم، موجودیت استخراج کنیم، فراوانی واژهها را بسنجیم یا داده را برای مدل Machine Learning آماده کنیم. انتخاب Pipeline باید از هدف نهایی شروع شود.
Unicode و Encoding
یکی از پایههای کار با متن، فهم Encoding است. متن داخل رایانه به Byte تبدیل میشود و اگر Encoding مبدأ و مقصد هماهنگ نباشند، کاراکترها خراب دیده میشوند. UTF-8 امروز یکی از رایجترین Encodingهاست.
در Python 3 تفاوت میان str و bytes اهمیت دارد. str متن Unicode است و bytes داده باینری. هنگام خواندن فایل، API یا شبکه باید بدانیم در کدام سطح هستیم و Encoding چه زمانی اعمال میشود.
Normalization متن
دو رشته ممکن است برای چشم انسان یکسان به نظر برسند اما از نظر Unicode Representation متفاوت باشند. Unicode Normalization کمک میکند شکلهای معادل به فرم قابل مقایسه تبدیل شوند.
در زبانهای مختلف همچنین ممکن است لازم باشد Case Folding، حذف فاصله اضافی یا استانداردسازی علامتها انجام شود. اما Normalization نباید کورکورانه باشد؛ گاهی تفاوت Case یا علامت برای Task مهم است.
Tokenization
Tokenization متن را به واحدهای کوچکتر مانند جمله یا کلمه تقسیم میکند. تقسیم ساده بر اساس Space برای متن واقعی کافی نیست؛ علامتگذاری، مخفف، عدد، URL و ترکیبهای زبانی مرزها را پیچیده میکنند.
NLTK ابزارهایی برای Sentence Tokenization و Word Tokenization ارائه میکند. کتاب نشان میدهد Tokenizer چگونه انتخاب یا سفارشی شود و چرا کیفیت این مرحله روی تمام مراحل بعدی اثر دارد.
Sentence Tokenization
تشخیص مرز جمله فقط پیدا کردن نقطه نیست. نقطه میتواند داخل مخفف، عدد اعشاری یا نام باشد. Tokenizer جمله باید Context را تا حدی در نظر بگیرد.
برای Corpus خاص ممکن است مدل پیشفرض کافی نباشد و نیاز به Training یا Rule سفارشی وجود داشته باشد. متن پزشکی، حقوقی یا شبکه اجتماعی هرکدام الگوهای خاصی دارند.
Stopwords
Stopwordها واژههای بسیار رایجی هستند که در بعضی Taskها اطلاعات تمایزبخش کمی دارند. حذف آنها در Search یا مدل Bag-of-Words میتواند اندازه Feature Space را کاهش دهد.
اما حذف Stopword همیشه مناسب نیست. در Sentiment Analysis واژههایی مانند «نه» میتوانند معنای جمله را تغییر دهند. بنابراین Stopword List باید با Task سازگار باشد.
Stemming
Stemming تلاش میکند شکلهای صرفی مختلف واژه را به Stem مشترک کاهش دهد. این روش معمولاً Rule-based و سریع است و الزاماً یک واژه معتبر زبانی تولید نمیکند.
برای Information Retrieval این سادهسازی میتواند مفید باشد، اما در Taskهایی که معنای دقیق یا Grammar مهم است ممکن است بیش از حد تهاجمی باشد.
Lemmatization
Lemmatization به دنبال شکل پایه زبانی یا Lemma است و معمولاً از اطلاعات واژگانی یا Part of Speech استفاده میکند. نتیجه آن اغلب از Stemming طبیعیتر است.
انتخاب میان Stem و Lemma به هدف بستگی دارد. اگر سرعت و کاهش Vocabulary مهم باشد Stem مناسب است؛ اگر شکل واژگانی دقیقتر لازم باشد Lemmatization انتخاب بهتری است.
Part-of-Speech Tagging
POS Tagging به هر Token نقش دستوری مانند Noun، Verb یا Adjective اختصاص میدهد. این اطلاعات برای Parsing، استخراج عبارت و بعضی Taskهای Semantics مفید است.
Tagger بر اساس Context تصمیم میگیرد، زیرا یک واژه ممکن است در جملههای مختلف نقش متفاوتی داشته باشد. کیفیت Tokenization و زبان Corpus روی نتیجه Tagging اثر دارد.
ساخت Tagger
کتاب علاوه بر استفاده از Tagger آماده، منطق ساخت و ترکیب Taggerهای سادهتر را نیز بررسی میکند. میتوان از Default Tagger، Unigram، Bigram یا Ruleهای Backoff استفاده کرد.
این روش برای فهم نسل کلاسیک NLP بسیار ارزشمند است، زیرا نشان میدهد قبل از مدلهای عمیق چگونه اطلاعات Context بهصورت آماری وارد تصمیم میشد.
N-Grams
N-gram توالی N واحد زبانی است. Bigram دو Token و Trigram سه Token متوالی را در نظر میگیرد. این ساختار بخشی از Context محلی را حفظ میکند.
N-gramها در Language Modeling کلاسیک، Search، Feature Engineering و تحلیل Phrase کاربرد دارند. با افزایش N، تعداد ترکیبهای ممکن سریع رشد میکند و Sparse Data ایجاد میشود.
Frequency Distribution
شمارش فراوانی واژه یا Token یکی از سادهترین اما مفیدترین تحلیلهاست. Frequency Distribution میتواند واژههای پرتکرار، Long Tail و Patternهای اولیه Corpus را نشان دهد.
فراوانی خام همیشه کافی نیست، چون واژههای عمومی ممکن است غالب باشند. روشهایی مانند TF-IDF برای وزندهی بر اساس اهمیت سندی توسعه یافتهاند.
Collocations
Collocation ترکیبی از واژههاست که بیش از انتظار تصادفی کنار هم ظاهر میشوند. تشخیص Bigram یا Trigramهای معنادار برای Phrase Mining و تحلیل Corpus مفید است.
فقط فراوانی بالا کافی نیست؛ معیارهای آماری مانند PMI میتوانند میزان ارتباط را بهتر اندازه بگیرند.
Chunking
Chunking بین POS Tagging و Parsing کامل قرار میگیرد. هدف شناسایی گروههایی مانند Noun Phrase یا Verb Phrase بدون ساخت درخت نحوی کامل است.
با Ruleهای مبتنی بر POS Pattern میتوان Chunkهای اولیه ساخت. این روش برای استخراج عبارتهای اسمی یا Candidateهای موجودیت مفید است.
Chinking
Chinking برعکس Chunking بخشی از یک Chunk بزرگ را حذف میکند. ترکیب Chunk و Chink اجازه میدهد Patternهای زبانی دقیقتری تعریف شوند.
این ابزارها بهخصوص در سیستمهای Rule-based برای Domainهای محدود کاربرد دارند.
Named Entity Recognition
NER تلاش میکند نام شخص، سازمان، مکان، تاریخ و انواع موجودیت دیگر را در متن تشخیص دهد. این مرحله متن آزاد را به داده ساختاریافته نزدیک میکند.
کاربرد آن در خبر، جستوجو، تحلیل اسناد و Knowledge Base گسترده است. مدلهای قدیمیتر NER بر Feature و Tagger متکی بودند؛ امروز مدلهای Transformer دقت بسیار بالاتری دارند، اما مفهوم Task همان است.
WordNet
WordNet یک منبع واژگانی است که واژهها را بر اساس Synset و رابطههای معنایی سازماندهی میکند. میتوان Synonym، Hypernym، Hyponym و Relationهای دیگر را بررسی کرد.
این منبع برای Semantic Similarity و Word Sense exploration مفید است. البته پوشش و کیفیت آن برای همه زبانها یکسان نیست و نسخه انگلیسی قویترین کاربرد را دارد.
معنای واژه و ابهام
یک واژه میتواند چند Sense داشته باشد و انتخاب معنای درست به Context وابسته است. Word Sense Disambiguation از مسئلههای کلاسیک NLP است.
کتاب با ابزارهای واژگانی و Contextual روشهای کلاسیک را معرفی میکند. مدلهای زبانی جدید Representation زمینهای بسیار قویتری ساختهاند، اما مسئله ابهام همچنان بنیادی است.
Corpus و داده زبانی
Corpus مجموعهای سازمانیافته از متن است که برای تحلیل یا Training استفاده میشود. NLTK Corpusهای آموزشی مختلفی دارد و APIهایی برای دسترسی به آنها فراهم میکند.
شناخت Domain Corpus مهم است. مدلی که روی خبر آموزش دیده ممکن است روی Chat یا متن پزشکی عملکرد ضعیفی داشته باشد.
ساخت Corpus Reader
در پروژه واقعی ممکن است داده در Format اختصاصی باشد. ساخت Corpus Reader کمک میکند دسترسی به سند، جمله و Token استاندارد شود.
این جداسازی باعث میشود مراحل NLP از جزئیات File Layout مستقل بمانند و Pipeline قابل نگهداریتر شود.
Text Classification
در Text Classification هر سند یا جمله به یک Label اختصاص داده میشود. Spam Detection، Topic Classification و Sentiment Analysis نمونههای رایج هستند.
Pipeline کلاسیک شامل Tokenization، Feature Extraction، Training و Evaluation است. کیفیت Feature و Labelها اثر زیادی روی نتیجه دارد.
Bag of Words
Bag of Words ترتیب واژهها را نادیده میگیرد و سند را بر اساس Presence یا Count واژهها نمایش میدهد. با وجود سادگی، برای بسیاری از Classificationهای پایه Baseline خوبی است.
ضعف آن از دست دادن ترتیب و Context است. N-gramها میتوانند بخشی از این محدودیت را کاهش دهند.
Naive Bayes
Naive Bayes یکی از مدلهای کلاسیک Text Classification است. مدل با فرض استقلال سادهشده Featureها احتمال Class را محاسبه میکند.
فرض استقلال دقیق نیست، اما الگوریتم روی بسیاری از Datasetهای متنی عملکرد مناسبی دارد و برای آموزش رابطه میان Probability و Classification بسیار مفید است.
Feature Extraction
Feature میتواند وجود واژه، Count، N-gram، POS یا ویژگی Domain-specific باشد. انتخاب Feature مناسب گاهی از انتخاب Classifier مهمتر است.
Featureهای بسیار زیاد میتوانند Sparse Space ایجاد کنند و Training را دشوار کنند. Feature Selection یا Regularization برای کنترل مفید است.
Evaluation
Accuracy تنها Metric ممکن نیست. در Dataset نامتوازن باید Precision، Recall و F1 نیز بررسی شوند.
Train و Test باید جدا باشند و اگر Hyperparameter تنظیم میشود Validation جداگانه لازم است. استفاده مکرر از Test برای تصمیمگیری باعث Leakage ارزیابی میشود.
Confusion Matrix
Confusion Matrix نشان میدهد Model کدام Labelها را با یکدیگر اشتباه میگیرد. این ابزار برای Error Analysis بسیار مفید است.
با مشاهده نمونههای خطا میتوان ضعف Tokenizer، Label Noise یا Feature کمبود را پیدا کرد.
Regular Expression
Regex برای Patternهای متنی ساختاریافته بسیار قدرتمند است. استخراج شماره، تاریخ، Email یا Pattern محدود از کاربردهای آن است.
اما Regex برای فهم زبان طبیعی کامل مناسب نیست. Pattern بیش از حد پیچیده نگهداری را دشوار میکند و بهتر است در جای درست استفاده شود.
پاکسازی HTML
متن وب معمولاً Tag، Script، Navigation و Metadata دارد. پیش از NLP باید Content واقعی از Markup جدا شود.
حذف HTML با Regex عمومی روش قابل اعتمادی نیست؛ Parser مناسب ساختار Document را بهتر مدیریت میکند.
Pipeline پردازش متن
یک Pipeline حرفهای ممکن است شامل Decode، Normalize، Sentence Split، Tokenize، POS Tag، Feature Extraction و Model باشد. ترتیب مراحل روی خروجی اثر دارد.
Pipeline باید قابل تکرار باشد تا Training و Production دقیقاً یک Preprocessing داشته باشند. اختلاف کوچک میتواند Performance را کاهش دهد.
NLTK در برابر ابزارهای مدرن
NLTK برای آموزش مفاهیم NLP و روشهای کلاسیک بسیار ارزشمند است. امروز برای Production ابزارهایی مانند spaCy و مدلهای Transformer نیز بسیار رایج هستند.
این تفاوت ارزش کتاب را از بین نمیبرد. فهم Tokenization، Tagging، Corpus و Classification کلاسیک پایهای است که کمک میکند ابزارهای جدید کمتر جادویی به نظر برسند.
محدودیت نسخههای قدیمی Python و NLTK
این کتاب مربوط به نسل قدیمیتری از Python 3 و NLTK است. نام بعضی Functionها، Dataset Downloadها یا APIها ممکن است در نسخههای جدید تغییر کرده باشند.
برای اجرای مثالها بهتر است Environment جدا بسازید و هنگام خطا Documentation فعلی NLTK را بررسی کنید. Concept را حفظ و Syntax را به نسخه امروز ترجمه کنید.
کاربرد در Machine Learning مدرن
حتی در پروژهای که از Transformer استفاده میکند، مراحل Data Cleaning، Normalization، Dataset Split و Evaluation همچنان ضروری هستند. مدل بزرگ نیاز به مهندسی داده را حذف نمیکند.
همچنین Baselineهای ساده مانند TF-IDF + Linear Classifier میتوانند در Dataset کوچک بسیار رقابتی و ارزان باشند.
این کتاب برای چه کسانی مناسب است؟
- برنامهنویسان Python که میخواهند NLP را از پایه یاد بگیرند.
- دانشجویان پردازش زبان طبیعی و Text Mining.
- تحلیلگران دادهای که با اسناد و متن سروکار دارند.
- افرادی که میخواهند NLTK را به شکل عملی استفاده کنند.
- توسعهدهندگانی که قبل از مدلهای Transformer میخواهند Pipeline کلاسیک NLP را بفهمند.
پیشنیازها
آشنایی با Python، List، Dictionary، Function، File I/O و Regular Expression مطالعه را آسانتر میکند. دانش مقدماتی Probability برای Classification مفید است اما ضروری نیست.
روش پیشنهادی مطالعه
یک Corpus کوچک واقعی انتخاب کنید؛ مثلاً مجموعه خبر یا Review. ابتدا Tokenization و Frequency Analysis انجام دهید، سپس POS Tagging و در پایان یک Classifier ساده بسازید. نتیجه هر مرحله را مشاهده کنید.
همان Pipeline را بعداً با ابزار مدرنتر مانند spaCy یا یک Transformer مقایسه کنید. این مقایسه نشان میدهد کدام بخش مربوط به اصول NLP و کدام بخش مربوط به نسل خاصی از ابزارهاست.
جمعبندی
کتاب پردازش متن با Python 3 اثر Jacob Perkins یک منبع عملی برای تبدیل متن خام به داده قابل تحلیل است. مباحث آن از Unicode، Normalization و Tokenization شروع میشوند و به Stemming، Lemmatization، POS Tagging، Chunking، WordNet، NER، Corpus و Text Classification میرسند.
اگرچه APIهای NLTK و Python از زمان انتشار کتاب تغییر کردهاند، مفاهیم اصلی آن همچنان برای فهم NLP ضروری هستند. برای کسی که میخواهد قبل از ورود مستقیم به مدلهای بزرگ زبانی، ساختار واقعی یک Pipeline پردازش متن را بفهمد، این فایل میتواند منبع آموزشی مفیدی باشد.



نقد و بررسیها
هنوز بررسیای ثبت نشده است.