
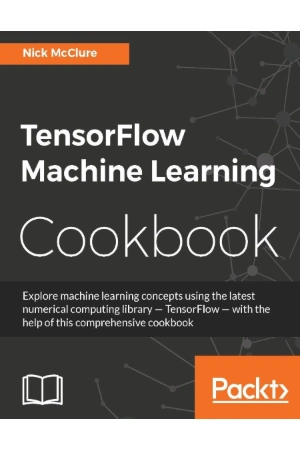
کتاب TensorFlow Machine Learning Cookbook (کتاب آشپزی یادگیری ماشین با TensorFlow) نسخه انگلیسی PDF
قیمت اصلی ۸۹.۰۰۰ تومان بود.۴۵.۰۰۰ تومانقیمت فعلی ۴۵.۰۰۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- تعداد صفحات: 507 صفحه
- حجم فایل: 4.97 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
خرید و دانلود کتاب TensorFlow Machine Learning Cookbook نسخه انگلیسی PDF
کتاب TensorFlow Machine Learning Cookbook یک راهنمای پروژهمحور و دستورالعملی برای یادگیری ماشین با TensorFlow است. این کتاب به خواننده کمک میکند مفاهیم اصلی یادگیری ماشین را در قالب مثالهای عملی پیادهسازی کند و با فرایند ساخت، آموزش، ارزیابی و بهبود مدلهای دادهمحور آشنا شود.
ساختار کتاب آشپزی یادگیری ماشین با TensorFlow بر مجموعهای از مسئلهها و راهحلهای اجرایی استوار است. هر بخش معمولاً یک هدف مشخص را دنبال میکند و نشان میدهد چگونه داده آماده شود، مدل تعریف گردد، تابع هزینه انتخاب شود و نتیجه آموزش مورد بررسی قرار گیرد.
معرفی کتاب TensorFlow Machine Learning Cookbook
TensorFlow چارچوبی برای انجام محاسبات عددی و ساخت مدلهای یادگیری ماشین و شبکههای عصبی است. این ابزار به برنامهنویسان اجازه میدهد عملیات ریاضی، پارامترهای قابل آموزش و جریان محاسبات را تعریف کنند و مدلها را روی دادههای واقعی اجرا نمایند.
کتاب TensorFlow Machine Learning Cookbook بهجای تمرکز صرف بر توضیحات نظری، موضوعات را در قالب دستورهای عملی ارائه میکند. خواننده میتواند هر مسئله را جداگانه مطالعه کند، کد را اجرا نماید و سپس آن را برای پروژه شخصی خود تغییر دهد.
این رویکرد برای افرادی مناسب است که مبانی پایتون و یادگیری ماشین را میشناسند اما برای تبدیل دانش نظری به کد اجرایی به مثالهای مرحلهبهمرحله نیاز دارند.
TensorFlow چیست و چه کاربردی دارد؟
TensorFlow یک چارچوب متنباز برای تعریف و اجرای محاسبات عددی است که در پروژههای یادگیری ماشین، یادگیری عمیق، پردازش تصویر، تحلیل متن و پیشبینی استفاده میشود.
مدلهای یادگیری ماشین شامل مجموعهای از پارامترها و عملیات ریاضی هستند. TensorFlow امکان تعریف این اجزا، محاسبه خطا و بهروزرسانی پارامترها را در جریان آموزش فراهم میکند.
یکی از مزایای مهم TensorFlow قابلیت اجرای محاسبات روی پردازندههای مختلف و مدیریت مدلهای دارای تعداد زیادی پارامتر است. این چارچوب در طول زمان تغییرات مهمی داشته و رابطهای برنامهنویسی نسخههای جدید آن ممکن است با کدهای نسخه مورد استفاده در کتاب تفاوت داشته باشند؛ با این حال، منطق مدلسازی و مفاهیم آموزشی کتاب همچنان ارزشمند است.
در کتاب TensorFlow Machine Learning Cookbook چه میآموزید؟
نصب و آمادهسازی محیط TensorFlow
کتاب از آمادهسازی محیط برنامهنویسی و بررسی اجزای اولیه TensorFlow آغاز میکند. خواننده با نحوه اجرای محاسبات، تعریف ثابتها و متغیرها و مدیریت دادههای ورودی آشنا میشود.
شناخت درست محیط اجرا باعث میشود در فصلهای بعدی بتوانید مثالها را بدون سردرگمی دنبال کنید و خطاهای مربوط به نوع داده یا ابعاد آرایهها را بهتر تشخیص دهید.
کار با تانسورها
تانسور ساختار اصلی نگهداری داده در TensorFlow است. یک تانسور میتواند یک مقدار منفرد، بردار، ماتریس یا آرایهای با ابعاد بیشتر باشد.
کتاب نحوه ساخت تانسورها، تغییر شکل آنها، انجام عملیات ریاضی و بررسی ابعاد را توضیح میدهد. درک شکل داده برای جلوگیری از ناسازگاری ورودی و خروجی مدل اهمیت زیادی دارد.
متغیرها و پارامترهای قابل آموزش
وزنها و بایاسهای مدل در قالب متغیرهای قابل آموزش نگهداری میشوند. الگوریتم بهینهسازی این پارامترها را بر اساس خطای مدل تغییر میدهد.
خواننده میآموزد چگونه پارامترها را مقداردهی اولیه کند، آنها را در محاسبات وارد نماید و نتیجه تغییرات را طی آموزش مشاهده کند.
دریافت و آمادهسازی دادهها
مدل بدون داده مناسب نمیتواند نتیجه قابل اعتماد تولید کند. کتاب به روشهای آمادهسازی ورودی، تبدیل مقادیر و تقسیم داده میان آموزش و آزمایش توجه دارد.
استانداردسازی، نرمالسازی و مدیریت دادههای ناقص میتوانند بر سرعت همگرایی و کیفیت پیشبینی اثر بگذارند.
تابع هزینه و اندازهگیری خطا
تابع هزینه میزان اختلاف میان پیشبینی مدل و پاسخ واقعی را اندازهگیری میکند. انتخاب تابع مناسب به نوع مسئله بستگی دارد.
در مسائل رگرسیون معمولاً فاصله عددی میان مقدار پیشبینیشده و مقدار واقعی مهم است، در حالی که در طبقهبندی از توابعی استفاده میشود که احتمال تعلق نمونه به کلاسها را ارزیابی میکنند.
گرادیان کاهشی و بهینهسازی
الگوریتمهای بهینهسازی تلاش میکنند مقدار تابع هزینه را کاهش دهند. گرادیان کاهشی و روشهای مرتبط، جهت تغییر پارامترهای مدل را بر اساس مشتق خطا تعیین میکنند.
کتاب به خواننده کمک میکند تأثیر نرخ یادگیری را درک کند. نرخ بسیار بزرگ میتواند آموزش را ناپایدار کند و نرخ بسیار کوچک ممکن است فرایند همگرایی را بیش از حد کند سازد.
رگرسیون خطی
رگرسیون خطی یکی از سادهترین مدلهای پیشبینی مقادیر پیوسته است. این مدل تلاش میکند رابطهای خطی میان ویژگیها و خروجی پیدا کند.
خواننده با تعریف پارامترها، محاسبه پیشبینی، اندازهگیری خطا و آموزش مدل رگرسیون در TensorFlow آشنا میشود.
رگرسیون لجستیک
رگرسیون لجستیک برای مسائل طبقهبندی به کار میرود و احتمال تعلق یک نمونه به یک گروه را تخمین میزند.
کتاب نحوه تبدیل خروجی مدل به احتمال، تعریف تابع هزینه مناسب و ارزیابی نتیجه طبقهبندی را بررسی میکند.
ماشین بردار پشتیبان
ماشین بردار پشتیبان تلاش میکند مرزی با حاشیه مناسب میان گروههای داده ایجاد کند. این الگوریتم در مسائل طبقهبندی و برخی مسائل رگرسیون کاربرد دارد.
مثالهای کتاب به درک مفهوم حاشیه، تابع هزینه و نحوه پیادهسازی مدلهای مبتنی بر مرز تصمیم کمک میکنند.
الگوریتم نزدیکترین همسایه
در روش نزدیکترین همسایه، پیشبینی بر اساس نمونههایی انجام میشود که از نظر ویژگیها به ورودی جدید نزدیکتر هستند.
کتاب نشان میدهد چگونه فاصله میان نمونهها محاسبه و از آن برای تصمیمگیری استفاده میشود. انتخاب معیار فاصله و تعداد همسایهها بر نتیجه اثر دارد.
خوشهبندی دادهها
خوشهبندی برای گروهبندی نمونههای مشابه بدون استفاده از برچسب از پیش تعیینشده کاربرد دارد. این روش در بخشبندی مشتریان، تحلیل الگو و اکتشاف داده استفاده میشود.
خواننده با منطق تعیین مراکز خوشه، تخصیص نمونهها و تکرار فرایند تا رسیدن به ساختاری پایدار آشنا میشود.
کاهش ابعاد
مجموعهدادههای دارای ویژگیهای فراوان ممکن است پردازش و مصورسازی را دشوار کنند. کاهش ابعاد تلاش میکند بخش مهم اطلاعات را در تعداد کمتری متغیر نمایش دهد.
این موضوع برای فشردهسازی، کاهش نویز و آمادهسازی داده پیش از آموزش مدل مفید است.
شبکههای عصبی مصنوعی
شبکه عصبی از لایههایی شامل واحدهای محاسباتی تشکیل میشود. هر واحد ورودیها را با وزنها ترکیب میکند و پس از عبور از تابع فعالسازی، خروجی را به لایه بعدی میفرستد.
کتاب نحوه تعریف لایهها، وزنها، بایاسها و تابع فعالسازی را در TensorFlow توضیح میدهد و مسیر ساخت یک شبکه چندلایه را نشان میدهد.
پسانتشار خطا
پسانتشار خطا فرایندی است که سهم پارامترهای مختلف در خطای خروجی را محاسبه میکند. این اطلاعات برای اصلاح وزنهای شبکه مورد استفاده قرار میگیرد.
درک این فرایند به خواننده کمک میکند بداند شبکه عصبی چگونه از نمونههای آموزشی یاد میگیرد.
توابع فعالسازی
توابع فعالسازی امکان مدلسازی روابط غیرخطی را فراهم میکنند. انتخاب تابع مناسب میتواند بر سرعت آموزش و توانایی مدل در یادگیری الگوها اثر بگذارد.
کتاب کاربرد توابع فعالسازی متداول را در معماریهای مختلف بررسی میکند.
شبکههای عصبی کانولوشنی
شبکههای کانولوشنی برای پردازش تصاویر و دادههای دارای ساختار مکانی طراحی شدهاند. فیلترهای کانولوشنی میتوانند ویژگیهایی مانند لبه، بافت و شکل را شناسایی کنند.
خواننده با لایه کانولوشن، نگاشت ویژگی و عملیات کاهش ابعاد آشنا میشود و میبیند چگونه این اجزا برای طبقهبندی تصویر در کنار یکدیگر قرار میگیرند.
پردازش و تشخیص تصویر
پیش از ورود تصویر به مدل، معمولاً لازم است اندازه، مقیاس و قالب آن استاندارد شود. افزایش داده نیز میتواند تنوع نمونههای آموزشی را بیشتر کند.
کتاب جریان کلی آمادهسازی تصویر، آموزش مدل و بررسی پیشبینیها را در قالب مثالهای عملی دنبال میکند.
شبکههای عصبی بازگشتی
شبکههای بازگشتی برای دادههای ترتیبی مانند متن، گفتار و سری زمانی مناسب هستند. این شبکهها بخشی از اطلاعات مراحل قبلی را در پردازش مرحله فعلی حفظ میکنند.
مثالهای مربوط به دنبالهها به خواننده کمک میکنند تفاوت دادههای مستقل و دادههایی را که ترتیب در آنها اهمیت دارد درک کند.
پردازش زبان طبیعی
برای استفاده از متن در مدلهای یادگیری ماشین باید واژهها و جملهها به نمایش عددی تبدیل شوند. این نمایش میتواند بر اساس شمارش، بردارهای ویژگی یا بازنماییهای آموختهشده ساخته شود.
کتاب نحوه آمادهسازی متن، ساخت ویژگیها و استفاده از مدل برای طبقهبندی یا تحلیل دادههای زبانی را بررسی میکند.
بردارهای کلمه
بردارهای کلمه تلاش میکنند واژگان را در فضایی عددی نمایش دهند که روابط معنایی یا کاربردی در آن منعکس شود.
این نمایشها در طبقهبندی متن، جستوجوی معنایی و مدلهای دنبالهای کاربرد دارند و پایه بسیاری از روشهای پردازش زبان طبیعی هستند.
تحلیل سریهای زمانی
دادههای زمانی شامل وابستگی میان مشاهدات متوالی هستند. پیشبینی فروش، تقاضا، سیگنال و رفتار سامانه از نمونههای کاربردی این نوع تحلیل است.
کتاب به ساخت دادههای دنبالهای و طراحی مدلهایی توجه دارد که بتوانند اطلاعات گذشته را در پیشبینی آینده وارد کنند.
ارزیابی مدلهای یادگیری ماشین
آموزش مدل پایان کار نیست. عملکرد باید روی دادههایی بررسی شود که در آموزش استفاده نشدهاند.
کتاب معیارهایی مانند خطا، دقت، بازخوانی و سایر شاخصهای متناسب با نوع مسئله را مطرح میکند و اهمیت انتخاب معیار صحیح را نشان میدهد.
اعتبارسنجی و جلوگیری از بیشبرازش
بیشبرازش زمانی رخ میدهد که مدل دادههای آموزشی را بسیار خوب یاد بگیرد اما روی نمونههای جدید عملکرد ضعیفی داشته باشد.
تقسیم صحیح داده، کنترل پیچیدگی مدل و استفاده از روشهای منظمسازی میتوانند به بهبود تعمیمپذیری کمک کنند.
ذخیره و بازیابی مدل
پس از آموزش، لازم است پارامترهای مدل ذخیره شوند تا بتوان آن را بدون آموزش مجدد استفاده کرد. ذخیره نقاط کنترل همچنین امکان ادامه آموزش را فراهم میکند.
کتاب به روند نگهداری پارامترها و بازیابی مدل در اجرای بعدی توجه دارد.
ساختار دستورالعملی کتاب چه مزیتی دارد؟
کتابهای Cookbook هر مسئله را به شکل یک دستور مستقل ارائه میکنند. این ساختار به خواننده اجازه میدهد بدون مطالعه خطی تمام فصلها، مستقیماً به موضوع موردنیاز مراجعه کند.
هر دستور عملی میتواند بهعنوان نمونه اولیه یک پروژه واقعی استفاده شود. پس از اجرای مثال، میتوان داده، معماری یا پارامترها را متناسب با مسئله جدید تغییر داد.
این قالب برای برنامهنویسانی مناسب است که در حین کار به یک مرجع سریع نیاز دارند و میخواهند نحوه پیادهسازی یک مفهوم را در کد مشاهده کنند.
کاربردهای عملی مطالب کتاب
پیشبینی مقادیر عددی
مدلهای رگرسیون میتوانند برای پیشبینی قیمت، فروش، تقاضا یا سایر خروجیهای پیوسته استفاده شوند.
طبقهبندی دادهها
الگوریتمهای طبقهبندی برای تشخیص گروه یک نمونه، شناسایی پیام ناخواسته یا تفکیک انواع داده کاربرد دارند.
بخشبندی و کشف الگو
روشهای بدون نظارت میتوانند نمونههای مشابه را گروهبندی کنند و ساختارهای پنهان مجموعهداده را نشان دهند.
تشخیص تصویر
شبکههای کانولوشنی برای شناسایی اشیا و الگوهای بصری در تصاویر مورد استفاده قرار میگیرند.
تحلیل متن
تبدیل متن به ویژگی عددی امکان طبقهبندی اسناد، تحلیل پیامها و استخراج الگوهای زبانی را فراهم میکند.
پیشبینی دنبالهها
شبکههای بازگشتی و مدلهای زمانی میتوانند از ترتیب داده برای پیشبینی مراحل بعدی استفاده کنند.
مهارتهایی که با مطالعه کتاب تقویت میشوند
تعریف مدل در TensorFlow: ساخت پارامترها، عملیات و جریان آموزش.
آمادهسازی داده: تبدیل ورودی خام به ساختار عددی مناسب برای مدل.
انتخاب تابع هزینه: استفاده از معیار متناسب با رگرسیون یا طبقهبندی.
تنظیم الگوریتم بهینهسازی: کنترل نرخ یادگیری و روند کاهش خطا.
ساخت شبکه عصبی: طراحی لایهها و انتخاب توابع فعالسازی.
تحلیل تصویر و متن: آمادهسازی دادههای غیرجدولی و استفاده از معماری مناسب.
ارزیابی مدل: مقایسه پیشبینیها و تشخیص بیشبرازش.
عیبیابی کد: بررسی ابعاد تانسورها، نوع داده و رفتار تابع هزینه.
کتاب TensorFlow Machine Learning Cookbook برای چه کسانی مناسب است؟
برنامهنویسان پایتون
توسعهدهندگانی که با پایتون آشنا هستند و میخواهند مدلهای یادگیری ماشین را با TensorFlow پیادهسازی کنند، از مثالهای عملی کتاب بهره خواهند برد.
دانشجویان علوم کامپیوتر و هوش مصنوعی
دانشجویان میتوانند این منبع را بهعنوان مکمل درسهای یادگیری ماشین، دادهکاوی، شبکههای عصبی و پردازش داده مطالعه کنند.
تحلیلگران و دانشمندان داده
افرادی که با تحلیل داده سروکار دارند میتوانند با استفاده از مثالهای کتاب، مدلهای پیشبینی و طبقهبندی را به گردش کار خود اضافه کنند.
توسعهدهندگان علاقهمند به یادگیری عمیق
مطالب مربوط به شبکههای عصبی، تصویر، متن و دنبالهها پایه مناسبی برای ورود به پروژههای یادگیری عمیق ایجاد میکنند.
پژوهشگران و مدرسها
مثالهای مستقل کتاب میتوانند برای آزمایش ایدهها، طراحی تمرین و نمایش عملی مفاهیم در کلاس مورد استفاده قرار گیرند.
پیشنیازهای مطالعه کتاب
آشنایی با مبانی پایتون، کار با آرایهها و مفاهیم مقدماتی جبر خطی برای دنبال کردن مثالها مفید است.
شناخت اولیه رگرسیون، طبقهبندی و شبکه عصبی باعث میشود خواننده ارتباط میان کد و منطق الگوریتم را سریعتر درک کند.
مطالب کتاب میتوانند برای یادگیری عملی استفاده شوند، اما مطالعه همزمان مبانی نظری به درک عمیقتر نتیجه مدلها کمک میکند.
نکته مهم درباره نسخه TensorFlow
کتابهای فنی بر اساس نسخه مشخصی از نرمافزار نوشته میشوند و TensorFlow نیز در طول زمان تغییرات مهمی داشته است. برخی مثالهای این کتاب ممکن است از الگوها و رابطهایی استفاده کنند که در نسخههای جدید تغییر کرده یا با روشهای تازه جایگزین شدهاند.
هنگام اجرای کدها بهتر است نسخه مورد استفاده کتاب با محیط شما مقایسه شود. در صورت استفاده از نسخه جدیدتر، ممکن است لازم باشد بعضی دستورها بر اساس مستندات همان نسخه بازنویسی شوند.
با وجود این تغییرات، مفاهیمی مانند تعریف پارامتر، تابع هزینه، بهینهسازی، ارزیابی و معماری شبکه همچنان برای یادگیری ماشین کاربردی هستند.
چرا مطالعه TensorFlow Machine Learning Cookbook مفید است؟
فاصله میان شناخت یک الگوریتم و پیادهسازی موفق آن میتواند زیاد باشد. کتابهای دستورالعملی این فاصله را با مثالهای کوچک و قابل اجرا کاهش میدهند.
این کتاب به خواننده امکان میدهد موضوعات مختلف را آزمایش کند، خروجی را ببیند و اثر تغییر پارامترها را در عمل بررسی نماید.
تنوع مسائل مطرحشده نیز به مخاطب کمک میکند تصویری گسترده از کاربرد TensorFlow در دادههای عددی، تصویر، متن و دنباله به دست آورد.
نسخه انگلیسی کتاب TensorFlow Machine Learning Cookbook با فرمت PDF
محصول حاضر شامل نسخه انگلیسی کتاب TensorFlow Machine Learning Cookbook با فرمت PDF است. فایل PDF را میتوان در رایانه، لپتاپ، تبلت و تلفن همراه مطالعه کرد.
مطالعه نسخه انگلیسی به کاربران کمک میکند اصطلاحات تخصصی TensorFlow، یادگیری ماشین و شبکههای عصبی را به زبان اصلی یاد بگیرند و برای مطالعه مستندات و منابع فنی آمادهتر شوند.
جمعبندی معرفی کتاب TensorFlow Machine Learning Cookbook
کتاب TensorFlow Machine Learning Cookbook نسخه انگلیسی PDF مجموعهای کاربردی از مثالها و دستورهای اجرایی برای ساخت مدلهای یادگیری ماشین با TensorFlow است. این کتاب موضوعاتی مانند تانسورها، آمادهسازی داده، رگرسیون، طبقهبندی، خوشهبندی، شبکههای عصبی، پردازش تصویر، تحلیل متن و مدلهای دنبالهای را پوشش میدهد.
برای برنامهنویسان، دانشجویان و تحلیلگرانی که میخواهند مفاهیم یادگیری ماشین را در قالب پروژههای عملی تمرین کنند، این کتاب میتواند مرجعی مفید و قابل مراجعه باشد.




نقد و بررسیها
هنوز بررسیای ثبت نشده است.