
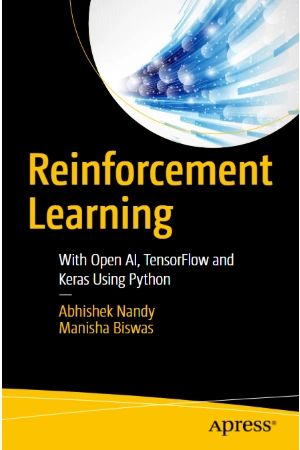

خرید و دانلود کتاب Reinforcement Learning اثر Abhishek Nandy و Manisha Biswas
قیمت اصلی ۸۹.۰۰۰ تومان بود.۴۵.۰۰۰ تومانقیمت فعلی ۴۵.۰۰۰ تومان است.
مشخصات فایل
- نوع فایل: PDF
- زبان: انگلیسی
- حجم فایل: 10.92 مگابایت
- قابل استفاده در: موبایل، تبلت، کامپیوتر
- نوع دسترسی: دانلود فوری بعد از خرید
آموزش یادگیری تقویتی با استفاده از زبان پایتون، OpenAI ،TensorFlow و Keras
ورود به دنیای هوش مصنوعی و یادگیری تقویتی (Reinforcement Learning)
یادگیری تقویتی یکی از جذابترین شاخههای یادگیری ماشین است که در آن برنامههای هوشمند (عاملها یا Agents) با تعامل با محیط اطراف خود و بر اساس سیستم پاداش و تنبیه، میآموزند که چگونه بهترین تصمیمات را بگیرند. کتاب Reinforcement Learning: With Open AI, TensorFlow and Keras Using Python نوشتهی Abhishek Nandy و Manisha Biswas، یک مسیر یادگیری گامبهگام را برای درک تئوریها و پیادهسازی این الگوریتمها فراهم میکند.
ساختار و الگوریتمهای کلیدی
این کتاب از مبانی نظری تا کدهای عملی را پوشش میدهد. برخی از مفاهیم و الگوریتمهای کلیدی که در این کتاب میآموزید عبارتند از:
الگوریتمهای Q-Learning و SARSA: تکنیکهایی کاربردی برای یافتن بهترین مسیرها و تصمیمگیری بر اساس یادگیری از تجربیات.
فرآیند تصمیمگیری مارکوف (MDP): چارچوبی ریاضی برای مدلسازی تصمیمگیریهای تصادفی و کنترلشده که در ساخت عاملهای هوشمند کاربرد فراوان دارد.
هوش گروهی (Swarm Intelligence): شبیهسازی رفتارهای جمعی و سازمانیافته مانند مسیریابی مورچهها و شبیهسازی جمعیت.
ابزارها و فریمورکهای قدرتمند
نویسندگان این کتاب تمرکز ویژهای بر پیادهسازی الگوریتمها با استفاده از فریمورکهای مدرن پایتون دارند:
OpenAI Gym و Universe: پلتفرمهایی برای شبیهسازی محیطها و آموزش هوش مصنوعی در بازیها (مانند Go و بازیهای آرکید) و برنامههای مختلف.
TensorFlow و Keras: فریمورکهای پیشرو برای ساخت شبکههای عصبی و پیادهسازی یادگیری تقویتی عمیق (Deep Q Learning).
کتابخانههای ChainerRL و MDP Toolbox: ابزارهایی برای پیادهسازی سریع و کارآمد فرآیندهای تصمیمگیری مارکوف و حل مسائل پیچیده.
کاربردهای دنیای واقعی و آیندهی هوش مصنوعی
در نهایت، این کتاب نشان میدهد که چگونه یادگیری تقویتی در صنایعی مانند تولید، مدیریت موجودی، سیستمهای تحویل و بخش مالی مورد استفاده قرار میگیرد. همچنین به بررسی پروژههای پیشگامی مانند Google DeepMind و الگوریتم AlphaGo میپردازد و به بحث دربارهی جنبههای مثبت و خطرات احتمالی آیندهی هوش مصنوعی (مانند نیاز به طراحی کلید توقف اضطراری یا Killswitch) اشاره میکند.




نقد و بررسیها
هنوز بررسیای ثبت نشده است.